<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="/feed.xml" rel="self" type="application/atom+xml" /><link href="/" rel="alternate" type="text/html" /><updated>2026-09-05T02:50:21+00:00</updated><id>/feed.xml</id><title type="html">虚实</title><subtitle>记录下折腾和学习的过程</subtitle><entry><title type="html">还没到35岁，就没班可上了</title><link href="/2026/09/05/%E8%BF%98%E6%B2%A1%E5%88%B035%E5%B2%81%EF%BC%8C%E5%B0%B1%E6%B2%A1%E7%8F%AD%E5%8F%AF%E4%B8%8A%E4%BA%86/" rel="alternate" type="text/html" title="还没到35岁，就没班可上了" /><published>2026-09-05T00:00:00+00:00</published><updated>2026-09-05T00:00:00+00:00</updated><id>/2026/09/05/%E8%BF%98%E6%B2%A1%E5%88%B035%E5%B2%81%EF%BC%8C%E5%B0%B1%E6%B2%A1%E7%8F%AD%E5%8F%AF%E4%B8%8A%E4%BA%86</id><content type="html" xml:base="/2026/09/05/%E8%BF%98%E6%B2%A1%E5%88%B035%E5%B2%81%EF%BC%8C%E5%B0%B1%E6%B2%A1%E7%8F%AD%E5%8F%AF%E4%B8%8A%E4%BA%86/"><![CDATA[<h2 id="一">一</h2>

<p>以前听人说程序员的35岁危机，总觉得还早。</p>

<p>做了十年技术，从安全、风控做到区块链，换过城市，换过公司，也换过行业。我习惯了一个办法：这边做不下去了，就学点新东西，去下一个地方。只要还能解决问题，总能找到一个需要我的团队。</p>

<p>现在还没到35岁，这个办法先不太管用了。</p>

<p>今年夏天，公司调整业务。我面前出现了两条路：拿补偿离开，或者转去一个新的交易方向，一个人做策略开发和研究，背上明确的利润指标。</p>

<p>我认真考虑过。新方向并非没有价值，但它已经和我原来想要的工作相差很远。</p>

<p>几个月前，我还在给自己安排接下来的生活：远程工作提供稳定收入，留出精力研究投资，重新开始写东西。工资是安全垫，其他事情慢慢来。</p>

<p>没想到最先需要重新讨论的，就是这块安全垫。</p>

<p>所谓“没班可上”，也不完全是没有岗位。更准确地说，是我熟悉的、愿意继续过下去的那种工作，越来越难找了。</p>

<h2 id="二">二</h2>

<p>我已经回到成都生活。</p>

<p>翻到2018年的博客，那时我还在一线城市折腾，写过一句话：</p>

<blockquote>
  <p>带着回到家乡过稳定的生活的愿望到处闯荡，大概是从血液里继承的命运吧。</p>
</blockquote>

<p>当时想要的事情其实很具体：有份能糊口的工作，能安静学技术，周末做做饭，和朋友见面。有机会的话，回家乡过这样的日子。</p>

<p>后来靠远程工作，这个愿望大体实现了。我不用为了一个工位决定住在哪座城市，也有了一些积蓄，不至于收入一停，生活就立刻出问题。</p>

<p>但我不敢说自己已经可以永远不工作。投资有赚有亏，未来的开支也不会按今天的计划走。过去挣到的钱，至少让我有了一段可以认真考虑下一步的时间。</p>

<p>奇怪的是，真有了这段时间，人并没有想象中轻松。</p>

<p>过去很容易知道一天该怎么过：有需求要交，有问题要修，有人等着你回复。忙的时候抱怨这些事情占满生活，等它们减少了，又会忍不住想，今天到底做成了什么？</p>

<p>以前盼着没人来安排我。现在才发现，自己安排自己，也是一门要重新学的手艺。</p>

<h2 id="三">三</h2>

<p>我时常想起刚进入Web3的那段时间。</p>

<p>2021年重新学习以太坊、Solidity和DeFi协议时，我发现这个行业已经不只是交易所里买币卖币了。钱怎样流动、抵押怎样成立、一个协议在哪里会出问题，都可以沿着代码往下看。</p>

<p>对一个做安全的人来说，这很有吸引力。以前研究系统哪里会被攻破，到了这里，代码里的漏洞直接连着真金白银。技术、规则和利益挤在同一个地方，复杂，也有意思。</p>

<p>2023年接受采访，被问到在Web3做什么，我的回答是：“在web3做自己。”</p>

<p>那时候是真的这么想。研究协议，找套利机会，和朋友做项目，不必每件事都等一个组织来批准。虽然也惦记着牛市，惦记着赚钱，但确实觉得自己走进了一个还有很多东西可以折腾的地方。</p>

<p>后来我也做过项目、带过团队，参与过追热点和找机会的生意。没有必要把过去写成只有理想，也不能把自己放在投机之外。</p>

<p>只是到了现在，永续合约、Meme、交易量，这些东西越来越占据我的视野。我能理解它们的商业逻辑，却越来越难像当年那样兴奋起来。</p>

<p>机会可能还在那里。变化的也有我自己：我开始在意，一件事情做完以后，除了收入，还能留下什么。</p>

<h2 id="四">四</h2>

<p>传统互联网呢？</p>

<p>我也想过回去。十年积累并没有消失，系统怎么拆，异常怎么处理，哪里需要风控，这些经验仍然有用。但再去适应一套组织、换一种生活，得到的东西是不是我现在需要的，要重新算。</p>

<p>年轻时，很多成本可以不算。换城市、加班、从头熟悉业务，都可以归到“成长”里面。到了今天，时间花在哪里，会直接影响生活过成什么样子。</p>

<p>我开始舍不得把整段时间交给一件自己并不认同的事。</p>

<p>AI又让这个问题变得更复杂。</p>

<p>我已经在用它写代码，也知道它能帮我省下多少工夫。一个想法从方案变成能跑的东西，比以前快了很多。越是亲手用过，越没办法把这些变化当成一阵热闹。</p>

<p>但我也知道，代码跑通以后，还有架构、边界条件、异常路径，还有上线以后谁来负责。十年经验没有突然失效，只是不能再指望凭着过去那套工作方式，一直走到退休。</p>

<p>这里有件挺矛盾的事：我一边担心自己的岗位，一边又真心觉得，现在是个人做东西最方便的时候。</p>

<p>工具越来越顺手，我却越来越拿不准该做什么。</p>

<h2 id="五">五</h2>

<p>我给自己写过人生OKR，也整理过职业经历和投资复盘。</p>

<p>写这些东西时并不缺方向：研究投资、积累知识、恢复写作，还有运动和好好生活。每一项拿出来，都值得做。</p>

<p>难的是第二天起来，具体先做哪一件，以及过了一个月，还愿不愿意继续做。</p>

<p>我做过一阵子很熟悉的事：建目录、迁笔记、做模板，把过去的记录归档。系统逐渐像样了，翻到进度表，却发现新文章没写几篇，周复盘也没有按计划开始。</p>

<p>这和写程序很像。搭框架、选工具、把结构整理漂亮，都是能得到即时反馈的工作。真正需要反复使用它、把东西交出去的时候，反而容易停下来。</p>

<p>投资也一样。过去的收益给了我一些选择权，却不会自动给我每天的秩序。要把它当成一件长期做的事，仍然得研究、记录、面对判断错误，不能只在有行情的时候觉得自己有事可干。</p>

<p>我可能还保留着上班时的习惯：等一个足够明确的目标，等有人告诉我，这件事做完是有用的。</p>

<p>现在这个确认，需要自己去找了。</p>

<h2 id="六">六</h2>

<p>初稿里，我说自己想要“纯粹的创造”。</p>

<p>写完以后觉得，这个词也有点方便。它可以用来解释我为什么不想做眼前的事情，却没有回答我究竟愿意做什么。</p>

<p>其实我以前做过不少没有人布置的东西。读CPython源码，写玩具编译器，试着用Java解释Python字节码。很多项目没做完，也没赚到钱，当时还是觉得挺好玩。</p>

<p>2018年的博客里，还记着一次工作中的小事：一个DSL要支持比较复杂的语法，问了一圈没找到办法，最后自己花了几天搞定了。过了这么多年再看，文字里那点高兴还在。</p>

<p>那时候并不需要先证明这件事能成为事业，才肯动手。</p>

<p>现在反倒会追问得很远：有市场吗？能持续吗？值得投入半年吗？如果最后只有我自己用，算不算白做？</p>

<p>这些问题都有道理。可每个念头刚出现，就要回答它们，最后很容易一个也留下不来。</p>

<p>也许可以先做一件我确实需要的小东西，自己用一阵，再看看别人是否也需要。或者把一次犯错的过程写清楚，哪怕只是给有相似困惑的人少走一点弯路。</p>

<p>暂时不知道它们能长成什么样，也可以开始。</p>

<h2 id="七">七</h2>

<p>所以先写这篇文章。</p>

<p>我还没有想清楚下一份工作是什么，也没有找到账户收益之外，足以让自己长期投入的事情。对Web3的失望、对AI的兴奋、对重新上班的犹豫，都还在。</p>

<p>写出来也不会立刻解决它们。</p>

<p>但翻过这些旧博客，我至少想起了自己曾经为什么喜欢写东西。一个问题终于弄懂了，一个轮子勉强跑起来了，一年过完，有些话想留给以后看。没有那么多定位和规划，也照样写了很多年。</p>

<p>现在可以把这件事捡回来。</p>

<p>下一篇写什么，笔记里已经有了：一个做过却没做成的项目，一次当时很笃定、后来发现错了的判断。把过程讲清楚，比再给自己找一个宏大的方向容易一点。</p>

<p>以前总觉得，等不那么忙了，就可以过自己想过的生活。</p>

<p>现在没那么忙了。接下来的事，得自己一点点做了。</p>]]></content><author><name>admin</name></author><category term="杂谈" /><summary type="html"><![CDATA[一]]></summary></entry><entry><title type="html">Claude Code时代的手动挡思维</title><link href="/2026/05/06/Claude-Code%E6%97%B6%E4%BB%A3%E7%9A%84%E6%89%8B%E5%8A%A8%E6%A1%A3%E6%80%9D%E7%BB%B4/" rel="alternate" type="text/html" title="Claude Code时代的手动挡思维" /><published>2026-05-06T00:00:00+00:00</published><updated>2026-05-06T00:00:00+00:00</updated><id>/2026/05/06/Claude-Code%E6%97%B6%E4%BB%A3%E7%9A%84%E6%89%8B%E5%8A%A8%E6%8C%A1%E6%80%9D%E7%BB%B4</id><content type="html" xml:base="/2026/05/06/Claude-Code%E6%97%B6%E4%BB%A3%E7%9A%84%E6%89%8B%E5%8A%A8%E6%A1%A3%E6%80%9D%E7%BB%B4/"><![CDATA[<p>卖掉BRZ那天，是个晴天。</p>

<p>下午三点的光打在蓝色车身上，金色轮毂折射出一圈碎光。绿头CD机放着《Tokyo Drift》——我从大学听到现在的碟，虽然从未学会漂移。交钥匙前发动了最后一次，FA20从低吟拉到高转。买家小我六岁，跳上车那一刻笑得像个孩子。</p>

<p>理想L7什么都会——自动泊车、NOA导航、语音控制。BRZ什么都不会——转速得自己听、补油得自己踩、跟趾得自己练。每个动作都是你和车在对话。</p>

<p>交钥匙那一刻我想起《禅与摩托车维修艺术》。Pirsig说，技术不是问题，问题是你和技术的关系。BRZ是古典理解——拆得开、听得懂、摸得着。L7是纯浪漫——舒服、聪明，但你不知道它内部在做什么。</p>

<p>不是卖一辆车。是古典向浪漫的投降。</p>

<hr />

<p>但卖车归卖车。写代码这件事，我没有完全交给自动驾驶。</p>

<p>我现在只用Claude Code，IDE早卸了。但我跟新手用AI是两回事。新手是 spec acceptance——”帮我写一个登录系统”，丢需求，收代码，跑通了就过了。我是 spec coding——先理解业务、拆PRD、画时序图、写技术方案，然后再把方案丢给AI执行。</p>

<p>区别在哪？我写的不是 prompt，是 design doc。AI 在我手里不是代驾，是帮踩油门的——方向盘还在我手上。</p>

<p>效果很直观：交付速度翻了几倍，但质量没有下降。因为质量从来不是代码写得快决定的，是架构、边界条件、异常路径——这些东西 AI 猜不出来，只有你看过足够多的血能预判。</p>

<p>这就是Pirsig说的古典理解——你知道它为什么能跑，也知道它会在哪里炸。AI让你很快，但只有古典理解让你正确。</p>

<hr />

<p>深夜刷番茄小说，一本西溪旧月的《末世从AI觉醒开始崛起！》——写到320章还在连载，讲AI研发工程师重生后灵魂与AI融合，跑到修炼文明里搞元宇宙。推荐栏还有《AI取代程序员》《GPT之后，代码不再需要人类》《我被Copilot开除了》。</p>

<p>两层黑色幽默：这些大概率是AI生成的网文，在说AI会干掉程序员；而另一群程序员正用AI写网文收割稿费。套娃。</p>

<p>Pirsig警告过”鬼魂”：技术太聪明，你就看不见它背后的形式。当你只会prompt不会debug，只看得懂diff看不懂调用栈，你就从驾驶员变成了乘客。车还是能到目的地，但撞护栏的时候你不知道该打多少方向。</p>

<p>这不是危言耸听。会用Claude Code的人已经很多了，真正懂它生成什么的人少得可怜。</p>

<hr />

<p>两种方式，我都有体会。</p>

<p>开BRZ上龙泉山狮子堡：全程盘山路，右手挡杆和方向盘之间来回，左脚跟趾补油，耳朵追着FA20从两千转到七千转的声线变化。每个回头弯都在和物理定律谈判。到山顶手心全是汗，但你知道是自己开上来的。</p>

<p>Pirsig在书里有一段写摩旅时的状态——当你骑在摩托上，两手握把，身体随弯倾斜，整个世界被压缩成下一个弯、下一脚刹车、下一段路面。没有过去、没有未来，只有此刻。这就是心流。开手动挡上盘山路一样：转速表的每一次跳动都在把你钉在当下，你没法想昨晚的bug，没法想明天的站会。你在开车，仅此而已。</p>

<p>今年开L7自驾去了趟内蒙古。成都出发，两千多公里，NOA开着，座椅按摩开着。以前一个人开长途最多撑4小时，现在一天跑800公里，到了还能吃羊肉。不是吹NOA有多牛——是它帮你吃掉所有机械疲劳，把精力留给你真正需要判断的时刻。</p>

<p>这就是Claude Code的真相：不是让你变懒，是让你变快。AI替你写样板、撸测试、查日志，省掉的不是决策，是体力活。你省下来的精力，刚好够盯住它会不会在并发那里埋雷。</p>

<p>但有一说一，NOA开着的时候我确实不在心流里。座椅按摩加自适应巡航，人是松的。BRZ过弯我不敢走神，走神就是护栏；L7跑高速我敢走神——前面200公里都是直路。两个场景都对，区别在于你知道什么时候需要心流，什么时候可以放手。</p>

<hr />

<p>我投BTC的方式也像开BRZ。</p>

<p>2022年$22k建仓，不看K线，不追土狗，不碰合约。拿到就囤着，像开一辆老油车，不换新款也不羡慕隔壁加速。2024年底$100k附近分批卖出，近5倍。</p>

<p>段永平说”慢就是快”，币圈也一样。长持是对”确定性”的信仰，就像你相信一台水平对置发动机拉到七千转不会散架。</p>

<p>这是古典投资观——像Pirsig修摩托：耐心拆解，等待反馈，信任底层逻辑。</p>

<p>美股还没找到那支愿意握十年的标的。巴菲特说”没人愿意慢慢变富”，我倒不是不愿意，是还在学怎么在慢车道上平稳挂挡。</p>

<hr />

<p>《Tokyo Drift》还在手机里——虽然我从未学会漂移。有些事情不需要完成，只需要存在。车库角落还留着没用过的改装离合、一张富士赛道门票、一个永远不删的改装件购物车。</p>

<p>Pirsig骑老摩托穿越美国，不是反对新技术，是”维修”自己和世界的关系。我周末偶尔关掉AI，纯手动写一段代码，也不是抗拒——是确认自己还能和机器对话，而不是只会下命令。</p>

<p>真正的出路不是选择古典还是浪漫。是像Pirsig说的：保持gumption，保持对品质的敏感。用AI加速原型、生成样板，但核心逻辑自己把关。享受浪漫速度，保留古典深度。</p>

<p>未来属于会用车机的人。但出了bug还能修的人，才配得上那台车机。</p>

<p>BRZ卖了，我不后悔——两个世界我都去过。但无论方向盘怎么变，手还在。</p>]]></content><author><name>admin</name></author><category term="杂谈" /><summary type="html"><![CDATA[卖掉BRZ那天，是个晴天。]]></summary></entry><entry><title type="html">威胁情报系列（二）：威胁情报从哪里来</title><link href="/2020/02/04/how-to-collect-threat-intelligence/" rel="alternate" type="text/html" title="威胁情报系列（二）：威胁情报从哪里来" /><published>2020-02-04T00:00:00+00:00</published><updated>2020-02-04T00:00:00+00:00</updated><id>/2020/02/04/%E5%A8%81%E8%83%81%E6%83%85%E6%8A%A5%E7%B3%BB%E5%88%97%EF%BC%88%E4%BA%8C%EF%BC%89--%E5%A8%81%E8%83%81%E6%83%85%E6%8A%A5%E4%BB%8E%E5%93%AA%E9%87%8C%E6%9D%A5</id><content type="html" xml:base="/2020/02/04/how-to-collect-threat-intelligence/"><![CDATA[<h2 id="前言">前言</h2>

<p>上一篇<a href="/2020/01/12/what-is-threat-intelligence/">文章</a>中，我们介绍了什么是威胁情报，以及威胁情报相关的一些概念。</p>

<p>威胁情报在国内作为一个新兴事物，除了专业的乙方厂商，普通安全从业人员可能对其了解没有特别深入。导致了其在使用起来效果不甚明显，难以真正落地等问题。有很多甲方厂商都只是简单从网上收集未经筛选的开源情报直接使用，甚至有些小的乙方安全厂商的安全产品中也是如此使用威胁情报。希望通过本系列的介绍之后，大家能够把威胁情报技术真正运用到实际的安全工作中。</p>

<p>这里需要再次说明，本系列文章所讲诉的“威胁情报”为 IOC 情报，不包括广义上的攻击情报和漏洞情报等。各家 src 收集业务漏洞时所称的情报属于广义上的威胁情报，和我们要描述的内容无直接关系。不过在下一篇“威胁情报怎么用”中，我们将通过结合安全产品、和威胁情报所使用的大数据、实时计算等技术来将狭义的 IOC 情报所涉及到的技术扩展到安全防御的各个环节。</p>

<p>在本文中将从乙方威胁情报厂商视角讲一下威胁情报具体是怎么收集、生产、运营的，以及结合上篇文章中的基本概念简单介绍如何使用。通过了解专业团队是如何做可以加深对威胁情报本身的理解，以指导如何落地。</p>

<p>本文所指的乙方为国内比较有代表性的威胁情报厂商，如：<a href="https://s.tencent.com/research/report/">腾讯御见威胁情报中心</a>，<a href="https://ti.qianxin.com/">奇安信威胁情报中心</a> 以及 <a href="https://x.threatbook.cn">微步在线</a> 等。</p>

<p>威胁情报的自带属性之一就是共享，除了商业威胁情报厂商之外还有很多开源的情报社区，但是上面也有提到，开源社区的情报质量良莠不齐，大多靠社区中的热心安全研究员贡献，缺乏有效的运营手段，直接使用效果不佳。而商业威胁情报厂商有其特有的数据和渠道，并且有比较严谨的运营流程。但是商业 IOC 除了部分公开的分析文章中可以免费获取，其余都需收费才可使用。对于没有充足经费的乙方厂商，可以借鉴其生产、运营手段，利用开源的社区情报也可以获得一些的效果。</p>

<p>下面将从生产和运营两个方面开始介绍商业威胁情报厂商的业务流程。</p>

<h2 id="生产">生产</h2>

<p>威胁情报做为数据类产品，其生产流程和其他的数据类产品类似，都是先采集数据、处理数据、提取属性存入数据仓库、编写工程代码进行大数据处理，然后总结出专家经验后做出对应的自动化脚本，等到积累的样本足够多时便可以选择合适的机器学习算法构建模型。</p>

<div align="center">
  <img src="/imgs/threatintel/2/1-0.png" />
  <p>图 1-0 生产流程</p>
</div>

<p>让我们先回顾一下上一篇中提到过的威胁情报的层次中的痛苦金字塔，威胁情报的生产也可以参考该图来说明。</p>

<div align="center">
  <img src="/imgs/threatintel/2-1.png" />
  <p>图 1-1 威胁情报的层次</p>
</div>

<p>可以看到金字塔最底层的为文件样本 hash (这里的文件包括各个平台上的执行文件，doc 文档，js、vbs 脚本等等)。威胁情报业务也是从样本出发。</p>

<h3 id="样本层面">样本层面</h3>

<p>最原始的威胁情报即为杀毒软件厂商的病毒库，安全研究人员的样本分析文章，Vitrustotal 类多引擎查杀结果，Hybird Analysis 类在线沙箱等可以公开或者花钱购买到的恶意样本信息，而该类信息通常是由 hash 的形式提供(md5、sha1、sha2 等等)。</p>

<p>更深度的情报信息一般需要从样本出发加工，所以威胁情报业务的第一步即为收集尽量多的样本数据。</p>

<h4 id="样本收集">样本收集</h4>

<div align="center">
  <img src="/imgs/threatintel/2/1-2.png" />
  <p>图 1-2 样本收集渠道 </p>
</div>

<p>上面提到的奇安信和腾讯都有自己的杀毒软件(奇安信的前身为360企业安全，有360卫士的数据)，并有自己的病毒库。而微步模仿 Virustotal 做了在线沙箱，并提供样本上传后多引擎鉴定的能力，通过社区网站可以收集到很多个人提交的样本。</p>

<p>除了从社区被动收集，还可以通过数据交换来获取更多样本数据，比如给 Virustotal 提供沙箱引擎可以获得 Virustotal 反馈的数据，或者加入微软、IBM等厂商的情报交换系统，以及爬取开源社区的数据等等。</p>

<p>一些厂商的安全产品在用户许可的情况下也可以获取部分数据，比如企业级的终端杀毒产品、EDR产品，以及可以还原流量中的文件的NTA产品等。NTA类的产品还可以和运营商合作使用流量分析技术还原互联网流量中的文件数据。</p>

<p>建立蜜罐系统也可以收集到投递进蜜罐的样本。</p>

<h4 id="样本鉴定">样本鉴定</h4>

<p>获取了足够多的样本后，接下来则是需要鉴定样本。这里的鉴定除了鉴定样本是否恶意(黑、白、灰)之外，还需要能给出样本的病毒名(包括家族名)。</p>

<p>如 VT 上的这个 <a href="https://www.virustotal.com/gui/file/d9083451b21c797cf9453a339a9319f4d3245eac841d70ba6acdd8e601a04c98/detection">Sality 样本</a></p>

<div align="center">
  <img src="/imgs/threatintel/2/1-3.png" />
  <p>图 1-3 示例 Sality 病毒名 </p>
</div>

<p>病毒名 <code class="language-plaintext highlighter-rouge">TrojanDropper:Win32/Sality.AU</code> 中，<code class="language-plaintext highlighter-rouge">TrojanDropper</code> 是样本的恶意类型，即”木马投递”，<code class="language-plaintext highlighter-rouge">Win32</code> 描述病毒的针对的平台，即 Windows，<code class="language-plaintext highlighter-rouge">Sality</code> 是为了方便用户和病毒分析人员记忆取的名字，就像国内的病毒取名叫“熊猫烧香”一样。</p>

<p>鉴定恶意软件样本的方法一般有静态和动态两种类型。两种方法的输入都是样本文件，输出一般为文件的指纹(一般为 hash)。</p>

<p>建议阅读《恶意代码分析实战》进行更多了解。</p>

<div align="center">
  <img src="/imgs/threatintel/2/1-4.png" />
  <p>图 1-4 样本鉴定 </p>
</div>

<h4 id="静态鉴定">静态鉴定</h4>

<p>现在的静态鉴定常用的手段是使用云端多引擎查杀技术，即将新出现的疑似恶意的文件上传到云端，使用多个杀毒引擎同时对其鉴定。</p>

<p>例如上面引用的 <code class="language-plaintext highlighter-rouge">Sality</code> 样本，在 VT 上显示 71 个杀毒引擎有 65 个将其判断为恶意。</p>

<div align="center">
  <img src="/imgs/threatintel/2/1-5.png" />
  <p>图 1-5 多引擎鉴定 </p>
</div>

<p>除了使用多引擎技术查杀外，还可以使用 <a href="https://virustotal.github.io/yara/">yara</a> 类的文件特征匹配引擎来鉴定。</p>

<p>例如下面这个 <a href="https://github.com/Yara-Rules/rules/blob/master/malware/MALW_Emotet.yar"><code class="language-plaintext highlighter-rouge">Emotet</code></a> 家族的 yara 规则</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>rule Emotets{
meta:
  author = "pekeinfo"
  date = "2017-10-18"
  description = "Emotets"
strings:
  $mz = { 4d 5a }
  $cmovnz={ 0f 45 fb 0f 45 de }
  $mov_esp_0={ C7 04 24 00 00 00 00 89 44 24 0? }
  $_eax={ 89 E? 8D ?? 24 ?? 89 ?? FF D0 83 EC 04 }
condition:
  ($mz at 0 and $_eax in( 0x2854..0x4000)) and ($cmovnz or $mov_esp_0)
}
</code></pre></div></div>

<p>通过对样本的逆向分析找出关键代码，可以编写出匹配 PE 文件特定偏移中出现的机器码的 yara 规则。</p>

<p>除了专家规则，通过积累的大量恶意样本和总结的专家经验，可以选择出合适的机器学习算法来训练有效的查杀模型。例如360的 QVM。</p>

<p>VT 上也有很多厂商在判断新样本的时候会给出一个含有百分比的标签，这种也是算法给出的一个判断，但是这一类的算法有个问题是只能判断黑白灰的概率，无法给出准确的家族鉴定。</p>

<h4 id="动态鉴定">动态鉴定</h4>

<p>动态样本鉴定一般使用沙箱技术，比较出名的开源沙箱如 <a href="https://cuckoo.sh/docs/">Cuckoo</a>，会在虚拟机中将样本运行起来，记录下样本运行时的各类系统调用和关键行为，并提取读写注册表、创建互斥体、创建释放文件、启动子进程、send、connect 外部地址等等关键行为，以及重点标注出虚拟机检测、自定义时间计算对抗虚拟机加速执行等恶意程序常用的方法。</p>

<p>例如 habo 上的样本 <a href="https://habo.qq.com/file/showdetail?md5=653317a379387b7c38b3ae568497ab4e&amp;pk="><code class="language-plaintext highlighter-rouge">order.docx</code></a></p>

<div align="center">
  <img src="/imgs/threatintel/2/1-6.png" />
  <p>图 1-6 沙箱结果示例 </p>
</div>

<p>标记出关键恶意行为只能判断样本是否恶意，或者得出基本的打分。要得到样本的家族分类，还需要有专家规则来做专门的鉴定，如 Cuckoo 有专门的 Signature 仓库 <a href="https://github.com/cuckoosandbox/community/tree/master/modules/signatures/windows">https://github.com/cuckoosandbox/community/tree/master/modules/signatures/windows</a>。</p>

<p>上面贴过了鉴定 <code class="language-plaintext highlighter-rouge">Emotet</code> 家族的 yara 规则，其使用的是文件中的字节码特征来鉴定。而 Cuckoo 沙箱也支持规则编写，动态鉴定时使用的则是进程 API 调用序列，Mutex名、注册表读写、网络请求等等特征。例如下面的 <code class="language-plaintext highlighter-rouge">Emotet Cuckoo Signature</code>:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>from lib.cuckoo.common.abstracts import Signature

class Emotet(Signature):
    name = "trojan_emotet"
    description = "Emotet Trojan Indicators Found"
    severity = 3
    categories = ["trojan"]
    families = ["emotet"]
    authors = ["RedSocks"]
    minimum = "2.0"

    mutexes_re = [
        ".*ci58c",
        ".*cm58c",
        ".*ci1a0",
        ".*rm974aade0",
    ]

    regkeys_re = [
        ".*974aade0",
    ]

    files_re = [
        ".*\\\\rqvkbvgl.exe",
    ]

    def on_complete(self):
        for indicator in self.mutexes_re:
            mutex = self.check_mutex(pattern=indicator, regex=True)
            if mutex:
                self.mark_ioc("mutex", mutex)

        for indicator in self.regkeys_re:
            regkey = self.check_key(pattern=indicator, regex=True)
            if regkey:
                self.mark_ioc("registry", regkey)

        for indicator in self.files_re:
            regkey = self.check_file(pattern=indicator, regex=True)
            if regkey:
                self.mark_ioc("file", regkey)

        return self.has_marks()
</code></pre></div></div>

<p>使用沙箱进行动态样本鉴定除了判断恶意和鉴定家族外，最重要的是提取样本的网络信息，以便后续通过数据处理实现 C2 的自动识别。要将情报的层次从样本级别提升到域名、ip 等基础设施这样更不易变的级别比较依赖动态数据，毕竟不是所有恶意程序都会傻乎乎的将c2地址直接硬编码到代码中。</p>

<p>沙箱虽然在威胁情报业务中十分重要，但是也存在集群部署成本高，研发和对抗困难等问题。除了收集样本到云端再在沙箱中运行，通过杀软、HIDS、EDR等产品采集数据也可以还原出部分关键数据，例如记录进程进行的网络请求、和敏感操作等。虽然没有 API 调用的完整序列，但是有了这些关键数据，并且数据量比自建的沙箱集群大很多，便可以进行后续的大数据分析了。</p>

<h4 id="家族分类">家族分类</h4>

<p>从上面的图 1-1 可以看出，样本的 hash 是最容易发生变化的数据，比如病毒样本文件随便添加几个字节即可导致其 hash 值发生变化。要得到有价值的信息除了刚才说到过的从行为日志中提取网络行为外，对样本家族进行分类也是十分重要的一点。</p>

<p><a href="https://en.wikipedia.org/wiki/Malware">恶意程序</a>也是由黑产从业人员或者团伙开发的软件，根据其功能大致分为有僵尸网络(bot net)、木马、蠕虫、病毒四种，其他还包括勒索软件和流氓软件等等。既然是软件就有不同的名字，虽然恶意软件作者不会自己给出名字，但是杀毒软件厂商会对其取名，并将同一种恶意软件的不同版本(变种)通过静态、动态查杀手段鉴定出来，归于一类。</p>

<p>例如 <code class="language-plaintext highlighter-rouge">Emotet</code> 银行木马家族在<a href="https://threats.kaspersky.com/en/threat/Trojan-Banker.Win32.Emotet/">卡巴斯基</a>上的病毒名为 <code class="language-plaintext highlighter-rouge">Trojan-Banker.Win32.Emotet</code>，说明了它是一个在 Windows 平台上运行的木马家族，家族名为 <code class="language-plaintext highlighter-rouge">Emotet</code>，就算其代码有部分更新，或者是样本 hash 发生了变化，杀毒软件鉴定成功后报毒时依然会叫 <code class="language-plaintext highlighter-rouge">Emotet</code>。</p>

<p>黑产人员开发恶意软件通常有其特殊的目的，如僵尸网络类的恶意软件会感染控制很多肉鸡组成僵尸网络，然后根据需要发起DDos攻击或者下发挖矿指令。而勒索软件则是会加密受感染电脑上的文件然后向用户索要赎金。家族分类就是为了将每种恶意软件的主要类型，攻击目标，以及使用的手法和手动查杀的方法积累下来。</p>

<p>比如微软给出的 <code class="language-plaintext highlighter-rouge">Rammit</code> 家族的<a href="https://www.microsoft.com/en-us/wdsi/threats/malware-encyclopedia-description?Name=Virus%3AWin32%2FRamnit.A">信息</a></p>

<div align="center">
  <img src="/imgs/threatintel/2/1-7.png" />
  <img src="/imgs/threatintel/2/1-7-2.png" />
  <p>图 1-7 家族信息示例 </p>
</div>

<h3 id="基础设施信息">基础设施信息</h3>

<p>在图1-1的痛苦金字塔中，文件样本 HASH 的上一层为主机特征和网络特征。其中主机特征为互斥体、运行路径、注册表项等沙箱动态鉴定器所使用的特征，大多需要安全专家人工分析总结得出。而网络特征中包括，IP、域名、URL 和通信协议，其中通信协议和主机特征一样，需要人工分析得出，可以编写为 IDS 规则，配合沙箱或者在网络流量中用于直接发现恶意软件的通信，但始终难以自动化得出。剩余的 IP、域名和 URL(URL中包含 ip 或者域名) 即为所谓的基础设施信息。</p>

<p><strong>基础设施是黑产人员的资产</strong>，相比样本 HASH 获取难度更高，但其稳定性能强，因为黑产人员要得到基础设施必须付出现实成本，通常也就是需要花钱购买，每一个 IP 背后都可能是一台主机(通常为云主机)，而域名也需要花费金钱购买。</p>

<p>而购买和使用基础设施必然会留下一些痕迹，通过这些痕迹便可以分析出更高维度的组织等信息，或者是通过这些痕迹将基础设施关联起来。例如说切换了域名但是都指向同一个 ip，或者是使用同一个个邮箱注册了多个域名。</p>

<p><strong>威胁情报对外输出的内容最主要便是IOC，并且大多是域名和IP等基础设施信息</strong>。<a href="https://en.wikipedia.org/wiki/Indicator_of_compromise">IOC</a>(Indicator of compromise) 即失陷检测指标，是威胁情报中最方便使用并且有效的数据。而根据其功能大致分为 C2 和传播源两种，如果在网络请求中检测到了 C2 访问，便基本可以判定内网中有主机被攻陷，这时再辅以端上采集的进程网络信息，排除浏览器等进程即可确认失陷。并且 C2 关联上恶意软件的类型和家族即可确认感染的是哪一种恶意软件，可能有什么危害，并确认清除方案和指导后续提升安全防护的措施。</p>

<p>说了半天基础设施信息的重要性，那么在威胁情报生产中基础设施究竟如何得到呢。</p>

<p>参考图 1-0 数据生产的流程。基础设施数据生产也是从样本出发，收集尽量多维度的信息，提取关系和属性，结构化存储后再进行数据处理后得到结果。只是和样本维度相比，要做基础设施生产需要收集的信息维度要多很多。存储所需要的大数据组件也更多样，处理的复杂性会高上很多倍。具体步骤如下图所示</p>

<div align="center">
  <img src="/imgs/threatintel/2/2-1.png" />
  <p>图 2-1 IOC生产流程 </p>
</div>

<p>首先要确定的就是要提取哪些关系和收集什么数据，这需要先梳理、观察数据，然后总结出来，结论可以直接参考 VT 上域名 <code class="language-plaintext highlighter-rouge">0-day.us</code> 的关系图：<a href="https://www.virustotal.com/gui/domain/0-day.us/relations">https://www.virustotal.com/gui/domain/0-day.us/relations</a></p>

<div align="center">
  <img src="/imgs/threatintel/2/2-2.png" />
  <p>图 2-2 VT关系示例 </p>
</div>

<p>可以看到 VT 的 Graph 中列举了:</p>
<ul>
  <li>域名的历史解析ip(dns、pdns 数据)</li>
  <li>子域名信息(dns分析可得出)</li>
  <li>域名下的 url 信息(从样本的网络行为中提取)</li>
  <li>和域名通信的样本信息(从样本的网络行为中提取)</li>
  <li>从域名下载的样本信息(也是从网络行为中提取)</li>
  <li>文件中包含域名信息的样本(静态样本鉴定时得到)</li>
</ul>

<p>在其他界面上还列举了:</p>
<ul>
  <li>域名的历史 whois 信息(域名是有时限的，到期可能不会续费或被他人购买)</li>
  <li>域名的历史证书信息(证书同理)</li>
</ul>

<p>除了上面的关系外，还需要有域名的 alexa 排名，多引擎判断结果(是否为钓鱼网站等恶意网站)等相关属性。</p>

<p>IP维度以及样本的关系和属性可以以此内推，因为太多太复杂就不一一列举了。这些关系和属性也是在日常和黑产的攻防对抗中逐渐总结出来的，上面已经提到过一些总结的逻辑了，这里也不再展开。</p>

<p>接下来我们从技术角度出发，讲一下如何存储并利用这些数据，建立完整的数据生产 pipeline。</p>

<p>这里想推荐一本书给大家，书名叫《Designing Data-Intensive Applications》。因为接下来会介绍相当多的大数据组件，这本书从全局的角度比较清晰的讲述了常见的大数据组件适合的存储与计算场景。</p>

<h4 id="数据存储">数据存储</h4>

<p>以上面的域名 <code class="language-plaintext highlighter-rouge">0-day.us</code> 为例，其数据来源不止一处，可能有非结构化的文本类数据，也有已经结构化存储到 db 的数据。数据的更新频率和需要存储的时间也各不相同。有些数据可以直接得到，而有些需要再次加工。</p>

<p>比如沙箱所产生的样本对应网络关系可能可以直接生成到 DB 中，而证书和 whois 信息等则可能是文本格式，并且需要数据处理才能提取出其中的域名和注册人等然后才能格式化存储。像IP对应的端口这类数据可能会快速变化需要ES等能快速检索按天更新的，而whois信息则变化相对较慢，可以存到 Hive 中，并将原始文本存储在 HDFS 或 <code class="language-plaintext highlighter-rouge">Ceph</code> 的对象存储系统中。而像域名这类有排名和类型判断等属性的数据可以存放在 Hbase 这类列存储中。</p>

<p>而最关键的则是存储域名、ip、样本之前关系所需要用到的<a href="https://en.wikipedia.org/wiki/Graph_database">图数据库</a>。因为传统的类似 MySQL 的数据库要存储关系只能将像域名映射 ip 这样的一个映射(也就是一条边)存储在一张表中，如果想要得到样本访问的域名对应的ip的话则需要 join 两张表，而通常关系处理都需要遍历多条边，使用传统数据库的话 SQL 调用会十分复杂性能消耗也会非常大，不利于使用。图数据库就是基本这种场景开发。常见的图数据库有下面几种：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: center">名称</th>
      <th style="text-align: center">存储引擎</th>
      <th style="text-align: center">支持计算</th>
      <th style="text-align: center">支持分布式</th>
      <th style="text-align: center">复杂性</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center"><a href="https://neo4j.com">neo4j</a></td>
      <td style="text-align: center">自带</td>
      <td style="text-align: center">自带</td>
      <td style="text-align: center">需付费</td>
      <td style="text-align: center">低</td>
    </tr>
    <tr>
      <td style="text-align: center"><a href="https://janusgraph.org/">JanusGraph</a></td>
      <td style="text-align: center">HBase、BigTable 等等</td>
      <td style="text-align: center">Spark、Hadoop</td>
      <td style="text-align: center">基于 Hadoop</td>
      <td style="text-align: center">高</td>
    </tr>
    <tr>
      <td style="text-align: center"><a href="https://janusgraph.org/">Haddop S2graph</a></td>
      <td style="text-align: center">HBase</td>
      <td style="text-align: center">否</td>
      <td style="text-align: center">是</td>
      <td style="text-align: center">高</td>
    </tr>
  </tbody>
</table>

<p>其中 neo4j 适合本地调试研究。S2graph 基于 HBase，适合大规模的图存储和知识图谱上的推理。而 JanusGraph 背后有 Google 支持，功能最丰富，除了支持知识推理外还支持图计算，如社群发现等。总结下来 JanusGraph 可能更合适使用，但是笔者在工作中对 S2graph 接触比较多，所以下面的图数据库都以 S2graph 为例。完整的数据存储流程图如下：</p>

<div align="center">
  <img src="/imgs/threatintel/2/2-3.png" />
  <p>图 2-3 数据存储流程图 </p>
</div>

<p>各个来源的数据，经过 ETL 和各种处理逻辑后统一汇总到 Hive 进行长期存储，然后再按天或者小时导入到 HBase 中。S2graph 底层使用 HBase 存储节点属性和边的数据，其他的 meta data 和 Hive 一样是存储在 DB 中的。数据按照 DB 中设置的节点属性和边的属性写入到 HBase 对应的表中即可在 S2Graph 使用 http api 进行关系查询。</p>

<h4 id="数据处理">数据处理</h4>

<p>数据收集上来之后，还需要经过处理才能够最终使用。</p>

<p>例如 DB 中的沙箱 API 调用日志中，需要遍历提取关键的 API，如 CONNECT 和 SEND 调用。从 DB 中读取该行调用，获取到对应的进程 md5 和 域名、ip 后写入 Hive 中。再按格式整理写入 HBase 才能在 HBase 中使用。</p>

<p>首先从在 Python 或者 Java 中读取 db 中沙箱已知恶意软件运行产生的数据。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>maleware_name = "rammit"
md5s = db.exec('select md5 from malware_samples where name like"%rammit%"')
for md5 in md5s:
    param1 = db.exec('select param1 from sandbox_apis_{date} where api_name="connect" and md5={md5}')
    if is_domain(param1):
        db.exec('insert into md5_visit_domain (md5,domain) values('%md5','%domain')', md5, domain)
</code></pre></div></div>

<p>然后需要从 db 导入到 Hive, 这一步一般由大数据任务平台实现，例如开源的 <a href="https://oozie.apache.org/">Apache Oozie</a>，Google 的 Google Cloud Dataflow，腾讯和阿里也有自己对应的实现(阿里的 ODPS 和腾讯的数据工厂)。</p>

<p>这些平台中可以创建 Hive、MapReduce 或 Spark 任务，然后给这些任务设置依赖关系，并设置定时调度。比如这里需要先建一个任务从沙箱结果的 MySql 表中导入到 Hive 临时表，再建一个任务依赖之前的任务并执行 Hive 语句写入结果表，最后在平台中到出到 HBase 中。</p>

<div align="center">
  <img src="/imgs/threatintel/2/2-4.png" />
  <p>图 2-4 大数据平台任务示例 </p>
</div>

<p>这一部分的数据处理主要涉及到 Hive 语句的使用，和使用 Java 开发特定的 Hive UDF 函数并上传到平台中在 Hive 里调用。平台中一般还会有资源管理、失败重试等等各类功能来保证业务的使用便捷性。像域名的热度数据也需要在 Hive 中根据 DNS 查询的数量在 Hive 中统计得出。更多具体 DB 和 Hive 的使用可以参考博客中<a href="https://woodrat.xyz/2018/10/09/seven-weapons-of-data-analysis-sql/">数据分析的七种武器-sql</a>和<a href="https://woodrat.xyz/2018/10/27/%E6%95%B0%E6%8D%AE%E5%88%86%E6%9E%90%E7%9A%84%E4%B8%83%E7%A7%8D%E6%AD%A6%E5%99%A8-hive/">数据分析的七种武器-hive</a> 等文章。</p>

<p>上面提到的属于批处理式任务，除此之外在一些时间要求比较严格的地方还需要使用实时计算技术，目前最火热的实时计算框架为 Apache Flink(这里也可以参考<a href="https://woodrat.xyz/2019/08/07/seven-weapons-of-data-analysis-flink/">数据分析的七种武器-flink</a>了解更多使用方式)，在威胁情报生成业务中，像一些特征较为明显的家族可以从网络访问中直接匹配特征发现其 C2，这样可以最快的产生有效的情报。</p>

<p>如VT上的这个 <a href="a5152db4636c7c4bda6dad1266bc1ab5e37deb0a52b90a218412c519aa77b7ef">Sality 样本</a>，从 Relation 界面可以看到其访问的 URL 为 <code class="language-plaintext highlighter-rouge">http://padrup.com/sobaka1.gif?44f62=1129864</code>，在统计大量的 Sality 样本后可以发现，其 URL 都满足 <code class="language-plaintext highlighter-rouge">\w+\.gif\?\d+=\d+</code> 这样一个正则格式，于是可以开发一个  Flink 任务匹配所有从 HIDS、EDR 上上报的网络流量，捞出满足该格式的 URL 并提取出其中的域名然后写入疑似恶意的域名库中。</p>

<p>在 Flink 中先将上报数据写入的 Kafka Topic 注册为 datasource，然后再将其注册为 table，比如叫 <code class="language-plaintext highlighter-rouge">md5_vist_url</code>。并创建 datastream 接受输出并sink到Hive，同时注册为 Flink table 名为 <code class="language-plaintext highlighter-rouge">suspected_domains</code>，然后编写 Flink SQL 语句如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Insert INTO suspected_domains
SELECT extract_domain(url) AS domain, "sality" FROM md5_vist_url WHERE regex('\w+\.gif\?\d+=\d+', url)
//其中 extract_domain 为 java 编写上传到 Flink 平台的 UDF。
</code></pre></div></div>

<p>使用实时计算技术实现一个规则引擎，再结合 <a href="https://attack.mitre.org/">ATT&amp;CK</a> 中总结的一些攻击手法还可以从 HIDS、EDR 上报的进程关系链中发现杀软无法发现的未知威胁(使用0day、nday，白加黑，无文件攻击等等)。例如最简单的发现一个 WORD.exe 拉起了以恶 CMD.exe 然后发起了网络请求，再比如提取 ATT&amp;CK 持久化常用的手法中常用的 bitsjob–[<code class="language-plaintext highlighter-rouge">BITSAdmin</code>]	(https://attack.mitre.org/techniques/T1197/)命令理写入的域名、ip，著名的 APT 攻击套件 <code class="language-plaintext highlighter-rouge">Cobalt Strike</code> 中就使用了该工具。仔细整理 ATT&amp;CK 手法再编写对应规则可以发现很多隐藏比较深的攻击，甚至可以抓到一些 0day，因为这个话题太大这里也不再继续展开。</p>

<p>说完了批处理部分和实时计算部分，情报生产的重头戏还是在知识图谱也就是 S2Graph 图数据库上。</p>

<p>所谓的<a href="https://en.wikipedia.org/wiki/Knowledge_Graph">知识图谱</a>是由 Google 提出的一种用图这种形式存储知识的数据库，图由节点(实体)、属性和边组成。例如 王小明今年13岁，他的爸爸叫王大明。这里描述的知识在图中可以表示为 两个节点，王小明和王大明，王小明节点有属性为年龄值为13。然后有一条边，由王小明指向王大明，边的名称为父亲代表大明是小明的父亲。如果这时再由王大明指向一个新的节点叫王老明，想在图中查找王小明的爷爷便可以从王小明节点往上遍历两条边得到。图如下：</p>

<div align="center">
  <img src="/imgs/threatintel/2/2-5.png" />
  <p>图 2-5 知识图谱示例 </p>
</div>

<p>这里举例寻找王小明爷爷的场景在知识图谱中叫做知识推理，知识图谱技术在搜索、推荐和风控等等领域都有许多应用，有时间的话可以阅读一下机器之心的这篇文章做更多了解 <a href="https://www.jiqizhixin.com/articles/2018-06-20-4">https://www.jiqizhixin.com/articles/2018-06-20-4</a>。</p>

<p>上面介绍威胁情报的基础设施信息(域名、ip)的时候已经介绍过 VT 上的图数据都有哪些节点和关系，如上面举例的 <code class="language-plaintext highlighter-rouge">0-day.us</code> 域名，在 VT 的<a href="https://www.virustotal.com/graph/0-day.us">图分析界面</a>中展示如下:</p>

<div align="center">
  <img src="/imgs/threatintel/2/2-6.png" />
  <p>图 2-6 情报图谱示例 </p>
</div>

<p>可以看到 <code class="language-plaintext highlighter-rouge">0-day.us</code> 连接的其他节点可以继续展开，也就是说在知识图谱中我们可以做多级关系的遍历，并且这种遍历也可以是双向的。然后一个域名可以有很多关联的访问该域名的程序，并且从域名出发可以列举出所有访问的程序，点击每个程序还可以获取其属性值(是否恶意等)。</p>

<p>基于图谱的以上三点特征我们可以总结出一条很简单的规则，即被大量相同恶意类型、不同 md5 样本访问的一个域名很有可能是某家族的 c2 域名。</p>

<p>在 S2Graph 中，提供了图查询的 http 接口，通过该接口我们可以实现上述的规则。该接口中需要指定开始的节点名即 <code class="language-plaintext highlighter-rouge">srcVertices</code> 以及索引到特定节点的值即id，然后指定要遍历的每条边，即 steps 中的 Json Object，其中 <code class="language-plaintext highlighter-rouge">label</code> 是边的名称，<code class="language-plaintext highlighter-rouge">direction</code> 是方向。因为 S2graph 的特殊设计，节点的属性也是一条边，不过是一条从节点出发指向节点本身的边。编写规则如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>curl -XPOST http://s2graph.localhost/queryedges -H 'Content-Type: Application/json' -d '
{
    "srcVertices": [{"serviceName": "column","columnName": "domain","id": "0-day.us"}],
    "steps":[
              {
                "step": [{"label": "md5_visit_domain","direction": "in","offset": 0,"limit": 10,"duplicate": "raw"}]
              },
              {  
                "step": [{"label": "md5_self_prop", "direction": "out","offset": 0,"limit": 10,"duplicate": "raw","where":"detection=malware"}]
              }
           ] 
}'
</code></pre></div></div>

<p>图谱中实体、属性和边的数据收集写入的过程在数据存储部分已经提到，该过程在知识图谱的概念中中叫出知识抽取，通过知识抽取我们可以搭建出完整的知识图谱。总结出各类规则对其中的数据进行利用。图谱中的节点和关系越多我们的规则会越接近真实，例如上面的这条规则，如果只有单一样本的数据，便只能使用传统的基于特征的规则。而在有了大量数据的情况下，知识图谱的推理计算能力便能发挥威力，能够自动化的发现很多以前光靠人工无法发现或者处理不过来的数据。</p>

<p>既然知识图谱也是图，那么除了知识推理外，其他的图算法也可以应用在知识图谱上。</p>

<p>比如<a href="https://en.wikipedia.org/wiki/Community_structure">社区发现算法</a>算法，该算法目的是在图中找到聚集的一堆节点。因为同一家族的恶意软件可能感染同过一批机器或者使用过相同的 ip 做 c2，天生就会具有聚集性，使用社区发现算法可以找出一批疑似恶意的域名。比较常用的社区发现算法有 Minimum-cut method、<a href="https://en.wikipedia.org/wiki/Girvan%E2%80%93Newman_algorithm">Girvan–Newman algorithm</a>等等。</p>

<p>从样本层面到基础设施层面，从人工分析到利用大数据和算法实现自动化，其实攻防的本质还是技术对抗。在人力有限的情况下使用更高层次和更自动化的手法才能和由利益驱动不断更新技术栈的黑产相对抗。在威胁情报产品中是这样，在其他安全产品里也是一样。</p>

<h2 id="运营">运营</h2>

<p>文章开头的时候提到过，乙方商业威胁情报厂商和普通的开源情报对比最明显的区别就是有没有运营环节，这里所说的运营包括人工运营和自动化运营。人工运营可以看作是最原始的恶意样本人工分析工作的延续，大多数安全产品在开发完善后都会进入一个长期的运营环节，因为所有安全产品最终的目的都是要发现真正的安全问题。就像威胁情报生产环节中发现的大多数恶意域名和 ip 其实都属于疑似恶意，到真正确认恶意并能对外使用还有很多步骤要走。</p>

<p>从海量的 ip、域名中发现真正的 c2 就和在网络流量中发现攻击类似，发现异常容易，但是要精准的发现攻击是一件很难的事情，毕竟攻击在整个流量中来看是一个小概率事件。恶意的 c2 在海量的ip、域名中也是属于极少数。因此，对 IOC 的质量可以有一个很简单的评价标准，如果使用某个 IOC 库在公司网络中一天的报警超过了 100 个，那么就和没有是一样的了，在大量误报中找到真正的报警是很难做到的。</p>

<p>威胁情报的运营和 WAF 等安全产品的运营也类似，首先就是建立自动化的数据漏斗，过滤大部分无用的数据。在这一步中，最普遍的就是建立黑白名单。</p>

<h3 id="白名单">白名单</h3>

<p>在以往威胁情报告警运营中，最令人尴尬的误报就是像 <code class="language-plaintext highlighter-rouge">baidu.com</code> <code class="language-plaintext highlighter-rouge">github.com</code> 等域名出现在了告警之中。如果商业版的威胁情报出现这一类的域名，不仅会让客户觉得产品不靠谱，甚至有可能导致订单被其他友商抢走。在甲方工作的过程中也见到过在做 dns 隧道检测和 DGA 域名预测时，告警中有不少 <code class="language-plaintext highlighter-rouge">aliyun.com</code> 之类云厂商 api 地址和一些内网域名或 ip，出现这种情况说明在工作时还不够谨慎。</p>

<p>所以威胁情报运营的第一步就是建立好白名单库，并且在不断的告警运营中将误报的 ip、域名补充到白名单中。像域名白名单可以下载 Alexa 排名前 10w 的域名或者再辅助以 dns 数据计算热度来产生。其他的 cdn 域名等也是常见误报来源。</p>

<p>而 ip 类的白名单则稍微会麻烦一些，并且 ip 类 c2 的失效速度会比域名快上许多。像小区宽带 ip 这一类需要购买外部数据，国内 ipip.net 有该数据售卖。而运营商骨干网 ip 等可以从 ASN 信息中得到，censys.io 等网站可以爬取一部分。最简单的内网 ip 需要首先排除，因为威胁情报给出的 IOC 是属于可以分享的互联网上的资产信息，内网攻击不在威胁情报 IOC 的覆盖范围内。甲方的运营分析人员使用威胁情报时，首先可以将内网的域名和ip加入到白名单中过滤。</p>

<div align="center">
  <img src="/imgs/threatintel/2/2-7.png" />
  <p>图 2-7 白名单建立 </p>
</div>

<p>白名单数据的数量一般不会太多，收集好白名单数据后可以存储在 MySQL 等 db 中，然后开发一个简单的管理系统来给其添加标签和删除错误数据等，并且该数据可以在多个安全产品间共享。</p>

<h3 id="黑名单">黑名单</h3>

<p>在 WAF 等安全产品中，会将攻击过的 ip 或者直接将所以云服务器的 ip 直接拦截，而威胁情报对外的形式也是类似一个黑名单库。不过有一些恶意的域名和 ip 不需要通过很长的流程即可生产。</p>

<p>第一类就是 Sinkhole ip 和 Sinkhole 域名，<a href="https://en.wikipedia.org/wiki/DNS_sinkhole">DNS Sinkhole</a> 是安全厂商对抗恶意软件的一种方式，即联系域名注册商将恶意软件使用的域名接管，解析到自己用于接管的 ip。所以内网中发现有连接到这些 Sinkhole ip 的请求多半已经被感染，Sinhole ip 可以直接用作 IOC，而解析到这些 ip 的域名同理。常见的 Sinkhole IP 列表可以参考这个 Github 仓库 <a href="https://github.com/brakmic/Sinkholes">https://github.com/brakmic/Sinkholes</a>。</p>

<p>第二类就是矿池的域名、ip 和 tor 节点 ip，通常在企业内网或者服务器上发现有连接矿池的请求时有很大几率是感染了挖矿木马或者是有员工违规利用公司资源在挖矿。国外有专门的网站收集 tor 节点信息，如 <a href="https://www.dan.me.uk/tornodes">https://www.dan.me.uk/tornodes</a>。更进一步可以爬取暗网中文交易论坛中的交易贴，分析隐私信息售卖的情况来监控企业是否发生了数据泄露。</p>

<p>第三类则是 DGA 域名，DGA 全称 <a href="https://en.wikipedia.org/wiki/Domain_generation_algorithm">Domain Generation Algorithm</a> 是恶意软件开发用于对抗情报类检测的功能，即在恶意软件内植入一个生成域名的算法，根据时间每天生成多个不同的域名，然后每天在注册其中某一个域名即可实现对感染机器的控制。在逆向恶意样本后安全分析人员可以还原出每个样本使用的 DGA 算法，在 Github 上有分安全分析人员共享了一些已经家族的 DGA 算法 <a href="https://github.com/pchaigno/dga-collection">https://github.com/pchaigno/dga-collection</a>，每天运行仓库中的脚本即可得到这些家族当天使用的 DGA 域名并检测。另外也有可以直接订阅 DGA 域名的网站 <a href="https://dgarchive.caad.fkie.fraunhofer.de/welcome/">https://dgarchive.caad.fkie.fraunhofer.de/welcome/</a>。除此之外，还可以使用熵值计算或者用已知家族的历史 DGA 域名通过深度学习算法(LSTM等)来预测。</p>

<p>还有就是上面提到过的分析文章中附带的 IOC 数据，这类数据可以人工阅读文章后通过运营系统添加到情报库，也可以通过 NLP 技术在爬取文章原文后自动标注。</p>

<div align="center">
  <img src="/imgs/threatintel/2/2-8.png" />
  <p>图 2-8 黑名单 </p>
</div>

<p>甲方安全团队在没有充足的经费购买商业情报库的情况下，可以参考黑白名单运营流程加上可信度高的开源情报库自建情报库。</p>

<h3 id="标签和ttp信息">标签和TTP信息</h3>

<p>在图 2-1 IOC生产流程中提到过，利用大数据生产威胁情报最主要的步骤叫做去白鉴黑。前期各种规则和算法都是在过滤出疑似的 IOC，而真正要对外输出的 IOC 需要是高可信的运营级 IOC。<strong>运营级是经过严格审核的可以用于生产环境边界或终端匹配拦截的 IOC</strong>，运营级需要有背景信息、威胁等级、处置建议等信息。例如下图的驱动人生木马团伙 IOC：</p>

<div align="center">
  <img src="/imgs/threatintel/2/2-9.png" />
  <p>图 2-9 驱动人生木马团伙 </p>
</div>

<p>在运营出白名单和黑名单后，可以自动化将疑似的 IOC 信息进行第一道过滤。而后还需要进行人工确认。并且通过一些自动化的手法给出标签和家族信息，再以标签、家族信息作索引来给予不同的风险等级和处置建议。简单来说如果某 IOC 在图谱中只被某一个样本家族访问而没有浏览器等白进程访问的化，那么可以将该样本的家族标签赋与该 IOC。而处置修复建议也和上文中提到的样本家族分类信息类似，只是在除了指导在终端上如何移除恶意程序外，还会有配置防火墙规则，或在域控中下发类似关闭 139、445端口服务等建议。</p>

<p>在积累了大量黑白样本后，即可使用 BOOST、决策树等算法从图谱中抽取各个维度的特征来训练出自动去白鉴黑的模型。</p>

<h3 id="告警运营">告警运营</h3>

<p>得到了运营级的情报库后，威胁情报的还需要有使用的载体，如 HIDS、SOC、NIDS、EDR 等。其中和 IOC 结合最好的还是 HIDS 和 EDR 类产品，因为它门可以收集端上的进程网络行为数据，这样告警的误报率最小，也方便后续的回溯分析。</p>

<p>在之前的工作中，除了生产威胁情报外还要运营公司各类安全产品中情报的告警，这些数据也是威胁情报生产的一个重要补充部分。当情报的准备率达到一个相对稳定的值后，告警数量不会太多，例如安全防护做的很不错的腾讯来说，每天新增的不重复告警不会超过 100 条。再加上帮客户运营告警数据后，人工分析每一个告警即可将可能会触发误报的 IOC 及时删除。比如在多个客户处发现 IOC 告警对应的进程基本是浏览器或 SVCHOST DNS 宿主进程的话该 IOC 基本可以判断是误报。</p>

<p>在告警运营过程中还可以将感染量大，但是出自一些自动化流程，标签和家族不明的 IOC 收集起来进行人工分析，很可能会发现一些新的家族类型。在这之后还能继续收集他们的 TTP 信息，再进一步整理其团伙信息。在某些情况下还可以定位到黑产团伙的具体人员信息，上报公安部分实施抓捕。</p>

<h2 id="总结">总结</h2>

<p>本文通过介绍乙方商业威胁情报厂商的生产运营流程，对如何通过大数据发现威胁情报的技术细节和公开的数据来源进行了简单的介绍。</p>

<p>接下来还有：</p>

<p>《威胁情报系列（三）：威胁情报怎么用》</p>

<p>敬请期待。</p>

<h2 id="参考阅读">参考阅读</h2>

<ul>
  <li>《恶意代码分析实战》</li>
  <li>《Designing Data-Intensive Applications》</li>
  <li>《知识图谱技术与应用指南》– <a href="https://www.jiqizhixin.com/articles/2018-06-20-4">https://www.jiqizhixin.com/articles/2018-06-20-4</a></li>
  <li><a href="https://blogs.akamai.com/2018/01/a-death-match-of-domain-generation-algorithms.html">https://blogs.akamai.com/2018/01/a-death-match-of-domain-generation-algorithms.html</a></li>
</ul>]]></content><author><name>admin</name></author><category term="安全" /><category term="威胁情报" /><summary type="html"><![CDATA[前言]]></summary></entry><entry><title type="html">威胁情报系列（一）：什么是威胁情报</title><link href="/2020/01/12/what-is-threat-intelligence/" rel="alternate" type="text/html" title="威胁情报系列（一）：什么是威胁情报" /><published>2020-01-12T00:00:00+00:00</published><updated>2020-01-12T00:00:00+00:00</updated><id>/2020/01/12/%E5%A8%81%E8%83%81%E6%83%85%E6%8A%A5%E7%B3%BB%E5%88%97%EF%BC%88%E4%B8%80%EF%BC%89--%E5%A8%81%E8%83%81%E6%83%85%E6%8A%A5%E6%98%AF%E4%BB%80%E4%B9%88</id><content type="html" xml:base="/2020/01/12/what-is-threat-intelligence/"><![CDATA[<h2 id="前言">前言</h2>

<p>威胁情报作为最近安全领域一个比较新也比较火热的领域，有其独特的业务和技术价值，从传统终端安全厂商到互联网公司的安全团队等安全从业者在建设威胁情报的过程中，实际上进行了一系列技术革新和对安全对抗本质的重新思考。</p>

<p>笔者 18 到 19 两年间在鹅厂的威胁情报团队参与并负责了部分威胁情报从零到一的建设，在接下来的系列文章中将通过威胁情报“是什么”、“从哪里来”、“怎么用” 三篇文章回顾一下这两年间积累的情报相关的知识(是什么)。并且顺带以业务团队的视角讲诉在这个过程中是怎么从传统样本对抗的思路到以搜索、大数据、知识图谱、实时计算、机器学习算法等技术来实现工程化、自动化和规模化的(从哪里来)，以及在拥有这些基础设施和商业数据后可以实现什么样的业务(怎么用)，再到怎么用这套打法扩展到业务安全等业务。</p>

<h2 id="背景">背景</h2>

<p>在开始正式介绍威胁情报前，想简单的科普一下该技术是怎么在国内突然进入快速发展阶段的。</p>

<p>互联网行业每隔一段时间便会有一个新的风口，处于风口的技术和企业都会以日新月异的速度飞快的发展。而企业安全行业则不同，目前为止在国内的总市场还不大，之前也主要是以绿盟、启明星辰、深信服为代表的传统安全厂商在其中血拼，所以其中的技术迭代速度还没有互联网公司这么快。但是由于大环境影响和时代的发展，PC 桌面时代彻底进入存量竞争期，PC 流量变现越来越困难。这时候，以安全为名实则为互联网公司(参考阅读 <a href="https://blog.csdn.net/XIAO_XIAO_C/article/details/82908529">《互联网三级火箭模式》</a>)的终端霸主 360 亲自入场企业安全领域。而用户量第二大的腾讯电脑管家也因为同样的原因跟进。以 360 和腾讯的体量以及它们拥有的数据、人才、技术储备，进入安全行业后造成了一次新的洗牌，改变了该行业的业务模式也带来了一轮新的技术升级。</p>

<p>还有一个众所周知的原因：即 2017 年 5 月的 <a href="https://en.wikipedia.org/wiki/WannaCry_ransomware_attack">WannaCry 勒索病毒事件</a>。 安全行业除了在少数情况下会被外部进入的资本和新玩家推动加速发展外，更多时候都发展都相对缓慢。但是一旦有影响非常重大信息安全的事件发生时，各行各业的注意力都会在短时间内聚焦在信息安全领域，这时候行业也会快速发展一次。</p>

<p>还记得 17 年 5 月的一个深夜，突然被领导的电话叫醒，一个负责写规则的室友还被叫回了公司应急，后来的事大家都知道了。</p>

<p>Wannacry 的作者使用了 <a href="https://en.wikipedia.org/wiki/The_Shadow_Brokers">Shadow Brokers</a> 泄露的 NSA 攻击工具包中的 EternalBlue 带的 <a href="https://en.wikipedia.org/wiki/EternalBlue">MS-17010 漏洞</a>(利用 smb ，和冲击波一样的可以 rce ，能造成蠕虫式传播的漏洞)，在短时间就感染了全世界范围内各大国家的政府、学校、医院等基础设施，造成了很大的损失以及心理冲击，并且带起了一阵制作勒索、挖矿病毒的风潮。我还记得第二天同学就发来了某高校图书馆和实验室电脑一片红的图片。后来公司也接到了医院的求助，因为勒索病毒造成了他们的设备不能正常使用。</p>

<div align="center">
  <img src="/imgs/threatintel/Wana_Decrypt0r_screenshot.png" />
  <p>WannaCry 感染截图</p>
</div>

<p>然而遗憾的是当时360安全卫士和腾讯电脑管家以及各大传统安全厂商的产品并未完全防御这次勒索病毒传播(很大一个原因是很多终端用户并未及时安装系统更新，其实微软在4月就推出了针对该漏洞的补丁，在这之后一两年都仍然有很多使用 ms-17010 的病毒在传播。只能说教育用户也是安全从业者需要做的工作之一，反过来看这也说明安全行业还有很大的发展空间)。这次事件迫使以 360、腾讯两家 c 端安全霸主、b 端安全的新玩家开始反思自身的安全建设不足之处: 即缺乏发现大盘(国内整体用户)中流行的病毒家族，以及活跃的黑产团伙并与之持续抗衡的手段。随着系统的不断建设和对数据理解的深入，这场建设对外表现为了威胁情报、APT 报告、安全大脑类产品等等各种形式，并促使了云安全产品在内的各类安全产品的技术和理念升级。</p>

<p>好了，闲话不再多说，让我们先从最基本的什么是威胁情报开始，进入威胁情报的世界。</p>

<h2 id="一威胁情报的定义">一、威胁情报的定义</h2>

<p>目前被引用最多的威胁情报的定义是2014年Gartner在其 《安全威胁情报服务市场指南》（Market Guide for Security Threat Intelligence Service）中提出的</p>

<p>“威胁情报是一种基于证据的知识，包括了情境、机制、指标、隐含和实际可行的建议。威胁情报描述了现存的、或者是即将出现针对资产的威胁或危险，并可以用于通知主体针对相关威胁或危险采取某种响应。”</p>

<p>Gartner 的定义中，对情报的信息量提出了明确的要求，在用于检测之外还需要提供复杂的背景信息以及针对管理者的建议等。</p>

<p><strong>通俗的讲，威胁情报是关于威胁的信息，利用公开的资源，用于发现威胁并指导企业行动以改善安全状况。</strong></p>

<p><strong>也可以说是，知道外面有哪些坏人(团伙)，他们都用什么样的技术，目标是谁。以及用什么东西(IOC)可以快速准确的检测有没有被他们攻击</strong></p>

<div align="center">
  <img src="/imgs/threatintel/1.png" />
  <p>图 1-1</p>
</div>

<p>威胁情报也可以理解为从 Unknown Unknowns 到 Known Unkonowns 的一种过程，即通过发现威胁存在的证据，知道威胁的存在。然后通过收集威胁的上下文及背景信息等，对威胁进行理解并缓解其危害程度就能从 Known Unkonowns 转移到 Known Knowns 状态。</p>

<p>英国的国家网络安全中心（NCSC）将威胁情报分为了以下四种：</p>

<ul>
  <li>
    <p>战略情报(Strategic Threat Intelligence)</p>
  </li>
  <li>
    <p>可操作情报(Operational Threat Intelligence)</p>
  </li>
  <li>
    <p>战术情报(Tactical Threat Intelligence) (TTPs)</p>
  </li>
  <li>
    <p>技术情报(Technical Threat Intelligence)</p>
  </li>
</ul>

<div align="center">
  <img src="/imgs/threatintel/2.png" />
  <p>图 1-2</p>
</div>

<p>接下来我们详细将介绍一下每个种类的威胁情报，并以御见威胁情报中心的使用场景为例方便各位理解。</p>

<h3 id="11-战略情报">1.1 战略情报</h3>

<p>战略级情报为总结型的信息，站在全局的角度，为决策层提供参考。<strong>通常为行业总览、攻击趋势等比较宏观的报告。</strong></p>

<p>例如御见威胁情报中心在 2 月 20 日发布的 <a href="https://s.tencent.com/research/report/654.html">《外贸从业者注意！陌生邮件可能暗藏木马窃取信息》</a> 报告。总结了近期针对外贸行业的攻击，攻击者使用带有宏病毒的 word 文档伪装为正常商务邮件，诱骗外贸行业的工作人员点击，点击后恶意的宏代码会下载“商贸信”病毒。</p>

<h3 id="12-可操作情报">1.2 可操作情报</h3>

<p><strong>可操作情报是针对特定组织即将发生的攻击的情报。</strong>例如一国外黑客组织最近针对国家重点单位的侦查变多，可能最近会发起对该重点单位的攻击。这一类的情报可能更容易被国家级别的情报收集单位收集到，普通的公司和个人很难接触到相关的信息。通过对开源公开情报进行分析和卧底私密的聊天论坛（irc 或 telegram）可能也能得到这一类的情报。</p>

<h3 id="13-战术情报">1.3 战术情报</h3>

<p>战术情报通常指 Tactics, Techniques, and Procedures (TTPs)，<strong>TTPs 是用来描述攻击者如何进行攻击的，即攻击者的方法，工具和策略。提供给甲方安全负责人和应急响应人员用于防御，告警，并在被攻击后的调查中使用。</strong></p>

<p>常见的 TTPS 包括：</p>

<ul>
  <li>
    <p>一个木马家族的特征</p>
  </li>
  <li>
    <p>一个特定木马变种的相关信息</p>
  </li>
  <li>
    <p>特定的攻击手法</p>
  </li>
  <li>
    <p>攻击者使用的基础设施信息（例如病毒使用的 c2 ip）</p>
  </li>
  <li>
    <p>攻击的目标信息</p>
  </li>
</ul>

<p>等等。</p>

<p>例如攻击者们在做内网渗透时会使用 <a href="https://github.com/gentilkiwi/mimikatz">Minikatz</a> 和魔改过或者混淆过的 Minikatz 来提取凭证（通常为 NTLM）进行爆破或者进行横向移动(<a href="https://www.crowdstrike.com/epp-101/lateral-movement/">Lateral movement</a>)。横向移动中可能会使用 PsExec 或者 WMI 接口进行 <a href="https://en.wikipedia.org/wiki/Pass_the_hash">pass the hass</a> 操作，如果没有本地管理员权限也可能使用 <a href="https://attack.mitre.org/techniques/T1097/">pass the ticket</a> 进行攻击。这种信息即战术情报。</p>

<p>通过配置策略防止域管理员登陆，以及使用SOC的流量探针或者 IDS 设置监控流量中的 PsExec 行为并配置相关的规则对该类行为进行监控。（关于 windows 横向移动攻击可以参考 <a href="https://zhuanlan.zhihu.com/p/34239250">《甲方安全建设之Windows横向移动攻击的检测》</a> 和 <a href="https://3gstudent.github.io/3gstudent.github.io/%E5%9F%9F%E6%B8%97%E9%80%8F-Pass-The-Hash%E7%9A%84%E5%AE%9E%E7%8E%B0/">《域渗透-Pass-The-Hash的实现》</a>）</p>

<p>战术情报通常是通过读公开的报告，对样本和组织进行分析，以及和别的厂商交换情报中获得。</p>

<p>例如御见威胁情报中心 2019-02-22 发布的 <a href="https://guanjia.qq.com/news/n1/2482.html">《盘一盘2018年那些难缠的顽固病毒木马》</a> 中便对2018 年中活跃的Bootkit/Rootkit 木马常用的技术手段、传播渠道、危害等进行了分析。</p>

<h3 id="14-技术情报">1.4 技术情报</h3>

<p>技术情报(Technical Threat Intelligence) 是特定恶意软件的指标（hash、域名、ip），是用于机读的可以用于自动化检测、分析的信息，相对来说 TTPs 主要是人读的情报。</p>

<p>技术级情报又可以称为失陷检测指标即 IOC (Indicator Of Compromise)，正如其名字，<strong>失陷检测指标即为可以用于提供给用户检测系统是否已被恶意软件或者攻击者攻陷，如果在系统内发现了这些指标即表明系统已被攻陷</strong>。</p>

<p>例如 2019-02-25 御见威胁情报中心发布的文章 <a href="https://s.tencent.com/research/report/657.html">《永恒之蓝下载器木马持续活跃：始于供应链攻击，不断变换攻击手法》</a> 中同时也发布了该事件相关的 IOC：</p>

<div align="center">
  <img src="/imgs/threatintel/3.png" />
  <p>图 1-3 IOC 示例</p>
</div>

<p>若在用户机器上检测到有非浏览器进程连接了“驱动人生木马”的 IOC 中的域名如： i.haqo.net，则用户可能已经感染了该木马，可以结合终端上的进程和网络日志等便可以定位该攻击，并进行后续的响应。</p>

<p>有人会说 TTPs 中也包含有 ip、域名等信息，和 IOC 有什么区别呢。 STIX 的文档中有一篇举了一个例子来讲 TTPs 和 IOC 的区别：</p>

<p>”TTP 描述了攻击者的行为和攻击方式，IOC 描述如何识别这些攻击行为。</p>

<p>伪造 100 元钞票的具体方法可以认为是 TTP，而通过水印等方法识别钞票是否是假钞的具体指导即为 IOC。”</p>

<p>TTPs 和 IOC 之间其实是可以联动的，通过 IOC 检测到内网安全威胁之后，IOC 可以反向索引到对应的 TTPs，以此为基础可以指导用户解决安全问题，找到后续提升安全防御能力的途径，并通过其追溯攻击者。</p>

<h2 id="二-威胁情报的层次">二、 威胁情报的层次</h2>

<div align="center">
  <img src="/imgs/threatintel/2-1.png" />
  <p>图 2-1 威胁情报的层次</p>
</div>

<p>广义的威胁情报中，按获取难度、准确度、信息量从低到高，依次为 :</p>

<ul>
  <li>
    <p>恶意文件的 hash</p>
  </li>
  <li>
    <p>主机特征（主要为 windows平台）：互斥体、运行路径、注册表项</p>
  </li>
  <li>
    <p>网络特征： ip、域名、url、通信协议</p>
  </li>
  <li>
    <p>事件特征（TTPs）：恶意团伙使用的技术手段，同一个团伙可能会使用类似的手段，可以作为定位团伙的证据</p>
  </li>
  <li>
    <p>组织：基于事件特征证据和其他信息，可能会分辨出多个攻击事件背后的同一个组织，并判定组织的来源、分工、资源状况、人员构成、行动目标等要素。</p>
  </li>
  <li>
    <p>人员情报：定位到攻击背后虚拟身份对应的真实人员身份，定位到人也就定位到了威胁的根源(比如定位了病毒的作者并掌握了证据即可实施抓捕)。</p>
  </li>
</ul>

<p>对应图 1-2，层次越高、有效时间越长的情报越难以获取。相对来说， TTPS 和 IOC（主机、网络特征，恶意文件 hash）等数据获取相对容易但是失效时间也更短。</p>

<p>其中文件样本 hash 和主机特征、网络特征都可以通过沙箱和数据分析等自动化手段生成。文件 hash 只需要攻击者修改文件的一两个字节便可修改，所以失效的速度是最快的，用于检测时更多是使用的是主机特征和网络特征。</p>

<p>其中主机特征（mutex、运行路径、命令行特征、注册表项）主要结合终端上的 EDR 产品使用。如果安装有终端 EDR 产品再结合 SOC 等安全大数据存储分析系统，安全效果最好。但是国内的现实情况是，除了腾讯、华为、阿里等等大型科技公司或者金融等安全意识较高的公司，很少有企业在办公环境和服务器环境中部署有终端EDR产品。</p>

<p>网络特征（ip、域名）可以应用于网络边界的流量检测系统中，如 IDS 类系统，也可以和 SOC 类系统联动，检测多种设备当前及过去的安全情况。</p>

<p>基于主机特征和网络特征做聚类分析，以及通过各个维度的相似度即可以将同一家族的恶意软件分类到一起。再根据 IOC 的上下文信息，找到攻击者的攻击攻击方法或者样本传播的渠道。这些信息即 TTPs 。</p>

<p>收集了多个独立家族和攻击样例后，可能可以分辨出多个家族背后是同一个团伙。例如同一个团伙可能会有自己开发的工具，或者固定的传播渠道，根据这些 TTPs 信息可能能够分析出背后的团伙。</p>

<p>在分析出组织后，通过受影响的地区、行业和普通用户能够大致分析出攻击者的目标群体，再辅以对样本包含的语言特征或者样本的伪装形势分析。也能大致查明攻击者的攻击目标和目的，在结合现实中的新闻等信息可以大概推断出攻击者的来源。</p>

<p>从对样本的分析开始，逐步收集技术手段等更多信息，最后定位到组织和其攻击目的这一过程，在 APT 攻击分析中有完整的体现。</p>
<h3 id="21-apt-分析一例">2.1 APT 分析一例</h3>

<p>参考腾讯御见威胁情报中心于2月26号发布的 APT 分析报告<a href="https://s.tencent.com/research/report/659.html">《响尾蛇（SideWinder）APT组织针对南亚的攻击活动披露》</a>，该报告中首先对发现的最新的攻击样本进行分析，得到攻击者使用的技术手段（TTPs 信息），和使用的网络特征（IOC信息）。然后通过攻击者使用的诱饵文件的内容判断攻击目标应该跟巴基斯坦相关，然后通过文档作者信息和另一个文档的投递使用的下载地址分析出目标跟巴基斯坦军方有关。最后得到了攻击者的组织信息如下图：</p>

<div align="center">
  <img src="/imgs/threatintel/2-2.png" />
  <p>图2-2 T-APT-04攻击者信息</p>
</div>

<h3 id="22-从样本出发找到关联">2.2 从样本出发找到关联</h3>

<p>在分析攻击时，可以使用各类分析平台如<a href="https://www.virustotal.com/">VirusTotal</a>、<a href="https://s.tencent.com/product/antu/index.html">腾讯安图高级威胁追溯系统</a>、<a href="https://ti.qianxin.com/">奇安信威胁情报中心</a>以及<a href="https://x.threatbook.cn/">微步威胁情报中心</a> 等通过对已知信息进行拓线分析，溯源攻击者来源。例如通过对样本外联的域名进行可视化分析，查询域名历史解析的 ip，发现攻击者使用的 ip 以及更多可能被用来发起过攻击的基础设施。</p>

<div align="center">
  <img src="/imgs/threatintel/2-3.png" />
  <p>图 2-3 使用安图的安全可视化分析界面分析 Bondat 蠕虫 </p>
</div>

<h3 id="23-关联到组织">2.3 关联到组织</h3>

<p>或是在分析一个 IOC 时，安图高级威胁追溯系统会通过安全知识图谱自动关联该 IOC 对应的组织信息，包括该组织的背景（来源、攻击目标、技术手段等等），投递样本使用的网络特征和样本的 C2 网络特征，以及该组织历史上的各类信息。</p>

<div align="center">
  <img src="/imgs/threatintel/2-4.png" />
  <p>图 2-4 安图关联团伙信息界面</p>
</div>

<p>在御见威胁情报中心发布的 APT 分析文章《疑似DarkHotel APT组织针对中国贸易行业高管的定向攻击披露》中，分析人员通过对捕捉到的 APT 样本进行分析，提取外联的 c2 服务器信息（IOC），在安图高级威胁追溯系统上通过该 IOC 关联到了更多的样本，并通过这些样本中提取的信息以及攻击方法，判断该攻击发起者疑似为 DarkHotel APT 组织。</p>

<div align="center">
  <img src="/imgs/threatintel/2-5.png" />
  <p>图 2-5 使用安图进行关联样本分析 </p>
</div>

<h3 id="24-定位到人">2.4 定位到人</h3>

<p>比组织信息更高层次的信息为人员信息，因为要完成虚拟身份到真实人员身份的映射需要很强的大数据安全分析系统和基础设施建设，一旦定位到人后便意味着战斗结束，因为一切威胁的最终源头还是人。</p>

<p>在这方法美帝投入了很多资源建设了 Xkeyscore系统。斯诺登在接收电视采访时曾说过：“在 <a href="https://en.wikipedia.org/wiki/XKeyscore">XKeyscore</a> 的帮助下，你可以阅读世界上任何人发送的邮件，获取所有网站的进出流量。并且可以追踪某一个的个人电脑，就算他在不同的地区之间移动。”。</p>

<p>XKeyscore 在现实中应用的结果可以参考去年美帝的发过的一篇对朝鲜黑客的指控 <a href="https://www.justice.gov/opa/press-release/file/1092091/download">MJ18-1479</a>，该指控中由FBI的一名专门追踪网络犯罪的特工对朝鲜黑客朴金赫做了有罪推定，断定了该人为朝鲜官方的黑客，参与并实施了多起网络攻击，包括：</p>

<p>2014 年对索尼影业的攻击（索尼影业 2014 上映了一部影片名为《刺杀金正恩》）。</p>

<p>参与编写了2017 年5月爆发的影响了全球的勒索病毒 WannaCry 。</p>

<p>攻击过美国军火商洛克希德马丁（该公司也是网络安全中 kill-chain 概念的提出者）。</p>

<p>攻击孟加拉国中心银行，盗取了 8100 万美元的资金。并分别在 15、16、17、18 年攻击过欧洲、亚洲、非洲以及北美和南美的其他国家的银行，造成了超过1百万美元以上的损失。</p>

<p>等等。</p>

<p>最后，指控中给出了朴金赫的个人信息：</p>

<ul>
  <li>
    <p>毕业于朝鲜金策大学(kut.edu.kp)</p>
  </li>
  <li>
    <p>2014年返回朝鲜</p>
  </li>
  <li>
    <p>Lazarus黑客小组的成员—隶属朝鲜Lab001—隶属朝鲜侦查总局。</p>
  </li>
</ul>

<p>指控中的举证章节列举了一系列的证据(引用自<a href="https://www.secpulse.com/archives/75460.html">《关注网络战——换个角度看美国对朝鲜黑客的指控(MJ-18-1479)》</a>)，包括：</p>

<p>tty198410@gmail.com、 watsonhenny@gmail.com 、yardgen@gmail.com 、jasmuttly@daum.net、 mrwangchung01@gmail.com 这几个邮箱用同一台机器访问过.</p>

<p>tty198410@gmail.com 这个邮箱的注册时间是2011年9月1日,注册时候填写的姓名是 “K YM”, 注册时候填写的恢复邮箱是 hyonu@hotmail.com,邮箱所有人在2014年9月至2015年5月挂着代理使用的这个邮箱.此邮箱账号的calendar服务时区设置为亚洲/平壤.</p>

<p>2013年11月,tty198410@gmail.com 注册了Rapid7账号(就是那个开发Metasploit的公司). 访问的IP是210.52.109.0-210.52.109.255(属于中国但在被朝鲜使用).</p>

<p>tty198410@gmail.com 使用”Kim HyonWu”名字注册过另一家网络安全公司的账号.</p>

<p>hyonu@hotmail.com 注册时间为 2007年3月13日,使用的语言是朝鲜语,注册位置是韩国首尔,注册名字是 “Kim Hyon Woo”.</p>

<p>hyonu@hotmail.com 在2007年4月23日使用IP#2在某知名软件论坛查看了软件编程相关的文章.</p>

<p>hyonwoo01@gmail.com此邮箱收到了N多邮件附件,每一个附件都被FBI探员成功恢复.里面涉及特马样本相关信息.或与DarkSeoul赛博攻击有关.</p>

<p>8）2015年12月4日在黑客论坛(hackforums.net)发帖 “我的邮箱是campbelldavid793@gmail.com 谁有doc exploit 发我一份”</p>

<div align="center">
  <img src="/imgs/threatintel/2-5.png" />
  <p>图 2-6 MJ18-1479 分析用图 </p>
</div>

<p>从该指控可以看出，美国通过对全网流量的持续监控以及对邮件服务商数据的获取，得到了 ip 访问指定邮箱，使用特定邮箱注册、登录网站，以及邮箱的备份邮箱这种普通人或机构完全得不到的信息。并且可以追溯到 2008 年（也就是 10 年以前）。通过大数据手段和情报收集基础设施的持续建设，使得美国最终可以达到威胁情报的最高层次，即定位到人。</p>

<h2 id="三总结">三、总结</h2>

<p>本文通过威胁情报的定义和威胁情报的层次，对威胁情报的概念和宏观的应用场景进行简单的介绍。在说明了什么是威胁情报后，接下来会在后续的文章中聊一聊威胁情报相关的具体技术细节，即如何通过大数据发现威胁情报，以及威胁情报在实际安全产品中的应用。</p>

<p>接下来还有：</p>

<p>《威胁情报系列（二）：威胁情报从哪里来》</p>

<p>《威胁情报系列（三）：威胁情报怎么用》</p>

<p>敬请期待。</p>

<h2 id="四参考阅读">四、参考阅读</h2>

<p>https://www.anquanke.com/post/id/164836</p>

<p>https://stixproject.github.io/documentation/concepts/ttp-vs-indicator/</p>

<p>https://ti.360.net/blog/articles/level-of-threat-intelligence/</p>

<p>https://www.ncsc.gov.uk/content/files/protected_files/guidance_files/MWR_Threat_Intelligence_whitepaper-2015.pdf</p>

<p>https://en.wikipedia.org/wiki/XKeyscore#According_to_Snowden_and_Greenwald</p>

<p>https://www.justice.gov/opa/press-release/file/1092091/download</p>

<p>https://www.secpulse.com/archives/75460.html</p>]]></content><author><name>admin</name></author><category term="安全" /><category term="威胁情报" /><summary type="html"><![CDATA[前言]]></summary></entry><entry><title type="html">2019安全产品回顾</title><link href="/2020/01/05/2019%E5%AE%89%E5%85%A8%E4%BA%A7%E5%93%81%E5%9B%9E%E9%A1%BE/" rel="alternate" type="text/html" title="2019安全产品回顾" /><published>2020-01-05T00:00:00+00:00</published><updated>2020-01-05T00:00:00+00:00</updated><id>/2020/01/05/2019%E5%AE%89%E5%85%A8%E4%BA%A7%E5%93%81%E5%9B%9E%E9%A1%BE</id><content type="html" xml:base="/2020/01/05/2019%E5%AE%89%E5%85%A8%E4%BA%A7%E5%93%81%E5%9B%9E%E9%A1%BE/"><![CDATA[<h1 id="今年做过的几个项目">今年做过的几个项目</h1>

<h2 id="tip">TIP</h2>

<p>在鹅厂完善了威胁情报生产运营后，开始探索具体应用的产品方向，最后定下做多源运营查询的威胁情报平台(TIP)。作为主要的研发负责人，参与了市场、产品调研到需求定制再到最后落地开发交付的整个过程。</p>

<p>从市场上看，整体的安全市场本就不大，具体到威胁情报这块的市场就更小了。并且现实的情况为国内大部分客户对威胁情报这种比较新的东西认识还不够也就造成了潜在的需求方并不多，只有那些有自己专业安全团队的大型公司才会有付费的意愿，并且这种类型的公司多半已经购买过不少安全设备并且有 soc 类的产品了，重型的产品想要打进去的机会就更加少了。在这种形式下，可以和 soc 产品相结合，并且可以集成多种商业情报和开源情报并提供查询、集成和管理的平台就成了一个可行的突破口。</p>

<p>产品层面，虽然整个安全市场中确实存在华而不实或者只是为了合规等原因做出的奇怪产品，我们的出发点还是以解决实际的安全为主，并且尽量将鹅厂实际的安全实践经验附加到我们产品中。具体来说，做为本身就是把威胁情报业务作为主要业务的组，产品核心的卖点之一就是要集成鹅厂对外的商业情报，将 TIP 作为一个承载情报的容器，通过 TIP 将情报一起以订阅模式卖出。另外一个重要的点就是将我们对业务也就是威胁情报的理解具象化到产品中。</p>

<p>首先，从我们的实战经验和业界友商们都统一的认知来说，域名/IP 类的 IOC 在实际场景中比较容易使用，也容易和已有的 SOC 类产品中的 DNS log 和 Flow log 集成。所以推送的情报目前以这两种为主是比较合理的。样本类的情报更新变化太快，而检测效果和匹配效率都不如前两个。更进一步的 TTP 情报基本很难落地，也很难量化售卖，现阶段基本不用考虑。</p>

<p>但单一的 IOC 是缺乏说服力的，作为专业的安全工程师，需要有数据辅助判断 IOC 的准确性，这个数据从外部来说就是类似 VirusTotal 的 Graph 中那样，一个 IOC 需要给出其关联的样本(以及样本的多引擎鉴定结果)，曾经解析过的 IP，更进一步如果有对应的分析文章就基本上稳了。在给出背景信息的过程中最好能够跳转到外部的分析平台，比如 VT、Malwares.com、微步以及鹅厂自家的安图等等。此外，也可以用开源的 STIX 格式类似的形式，根据 IOC 反向索引到 TTP，也就是攻击的手法，或者更具体的样本行为(文件路径、注册表、c2 特殊url、mutex等等)，这样既能更精准的判断告警的准确性，也可以辅助客户的安全人员排查解决问题。</p>

<p>除了解决安全问题这一个主要痛点，还需要有导入其他厂商情报，导入国标、STIX 等格式的文件，以及订阅开源的情报源等等。这方面可以参考 <a href="https://www.misp-project.org/">MISP</a>。</p>

<p>还有就是产品使用时会有一些运营需求，例如禁用某些产生误报的 IOC，或者禁用某些质量不够好的情报源(比如某一次从外部文件导入的一批情报)。以及给不同的来源设置不同的分数，客户安全团队人工在界面上添加新的自己捕获的 IOC 等。</p>

<p>考虑到有些客户规模比较大，内部会有不同的设备或者安全系统来调用 TIP 的 API，产品还需要提供基于 Appid 区分调用者，并且能控制每个 Appid 的开启和关闭。</p>

<p>除了上面提到的这些功能点，有一个大部分安全产品，或者说大部分控制台后台都会有的 Dashboard 功能，用以统计每天更新的情报数、每个 Appid 查询数量以及告警数量等。然后推送一些新的含有情报的报告，或者家族追踪文章，行业相关的安全新闻等。</p>

<p>技术上，这个产品最难的是在云端基于根据观察数据和大规模样本总结出来的专家规则、基于 att&amp;ck 定制的专有规则、机器学习模型、图聚类模型等等方法，使用大数据相关的技术来发现威胁。并通过层层去误报以及基于内部的告警运营去掉大部分误报，得到精准并可以直接用于发现对应类型威胁得 IOC。</p>

<p>具体到该系统本身，有几个最主要的难点。</p>

<ul>
  <li>
    <p>一个是需要将云端加密的文件放入内存提供查询服务，这些内部数据需要提供给客户离线查询，但是又不能被恶意的客户获取到全量明文。在此基础上加密数据还得和数据库中人工添加、导入的数据一同被索引。这需要实现几套不同的数据结构来存放不同来源的数据，并且要保证数据能够按照统一的格式返回。</p>
  </li>
  <li>
    <p>还有就是受制于架构，该系统需要做不少单机高性能的优化，得耐心地用 Go Profile 一个个找到性能消耗多的函数再仔细思考优化的方法。</p>
  </li>
  <li>
    <p>最后就是新闻推送之类的场景需要实现类似 kafka 一样的根据 id 来增量获取的机制，在部分失败后还可以根据 id 来逐个重试，在此基础上还需要能够把已经推送的新闻或者 IOC 给撤回。</p>
  </li>
</ul>

<h2 id="云防火墙">云防火墙</h2>

<p>下半年的时候，开启了一个新的云上安全产品的项目–<a href="https://cloud.tencent.com/product/cfw">云防火墙</a>。让我感到诧异的是腾讯云之前居然没有统一管控外网ip的地方。在这个方面AWS 有 <a href="https://aws.amazon.com/cn/firewall-manager/">firewall-manager</a>，而阿里云也有自己的<a href="https://www.aliyun.com/product/cfw">cfw</a>。</p>

<p>和传统的防火墙一样，云防火墙也具有南北向访问控制的能力。利用云厂商的优势和 SDN 等技术，云防火墙还可以实现租户网络拓扑图绘制，以及东西向的微服务间的安全管理等。</p>

<h3 id="南北向安全">南北向安全</h3>

<h4 id="入站">入站</h4>

<p>南北向安全有一个基本的需求，即统一管理所有对外的ip和端口。和 idc 环境只有若干有限的已知的出口 ip 不同，云上 cvm 可能在创建的时候可能就自带有一个 eip，并且可能还有 VPN 网关， 云LB 等等各种各样的服务，它们都具有自己的公网 ip。云防火墙需要汇集租户在云上所有的公网 ip、以及其对应的云产品，让用户像配置传统防火墙一样配置其入站的访问控制规则。用以防止不该暴露在公网的 ip 暴露在公网重，以及 ban 掉恶意攻击的 ip。</p>

<p>入站流量也可以像传统防火墙一样结合 IPS 的功能，对恶意的包做拦截。</p>

<p>有别于 IDC 环境，云上环境有其自身的复杂性。ECS 层面可能已经有用户配置的安全组策略，而虚拟主机上也可能会有云厂商自己的一些安全组策略，而这些策略在云防火墙这个层面不一定对客户可见。这里会造成客户对云防火墙规则之外的拦截感到迷惑。技术上这里需要将各安全产品的拦截日志汇总做对账，并且需要做到拦截行为能够回溯到对应的产品和规则。</p>

<p>在云防火墙的拦截实现上，不能像安全组一样直接在某个宿主机内核之类的地方实现类似 iptables 的丢包，而是需要利用 sdn 技术将符合对应源、目的ip和端口的包在 sdn controller 层面设置丢弃。简单一点的话也可以在所有云服务器机房的出口部署物理拦截设备。</p>

<h4 id="出站">出站</h4>

<p>出站的逻辑和入站基本一致，可以阻止后门程序连接到恶意 ip。不同的地方是，出站方向可以允许配置域名，防止 VPC 内的机器访问恶意的网站。或者配置只允许内网的机器访问镜像源之类的网站。</p>

<p>出站流量也可以结合其他安全产品，例如结合威胁情报发现内部已发生的威胁。或者将日志打到 SOC 类产品，统计分析是否有异常行为。</p>

<p>配置出战的域名拦截规则需要考虑存在很多 Https 的连接，需要通过流量中 HTTPS 的 SNI 值来判断对应的域名。</p>

<h3 id="东西向安全">东西向安全</h3>

<p>云防火墙产品除了互联网边界防护的功能外，还应该集成VPC网关防火墙、安全组(主机防火墙)的功能，做内网的网络隔离和访问控制。以及防止内网中的横向移动，阻止蠕虫类病毒在内网传播等。</p>

<p>实现上，可以结合流量分析和主机上的 HIDS 日志。</p>]]></content><author><name>admin</name></author><category term="安全" /><summary type="html"><![CDATA[今年做过的几个项目]]></summary></entry><entry><title type="html">数据分析的七种武器-flink</title><link href="/2019/08/07/seven-weapons-of-data-analysis-flink/" rel="alternate" type="text/html" title="数据分析的七种武器-flink" /><published>2019-08-07T00:00:00+00:00</published><updated>2019-08-07T00:00:00+00:00</updated><id>/2019/08/07/%E6%95%B0%E6%8D%AE%E5%88%86%E6%9E%90%E7%9A%84%E4%B8%83%E7%A7%8D%E6%AD%A6%E5%99%A8-flink</id><content type="html" xml:base="/2019/08/07/seven-weapons-of-data-analysis-flink/"><![CDATA[<p>Flink 是一个开源分布式流式处理引擎，支持将数据分发到多个节点，并提供容错机制(fault tolerance)，可以分布式的对流式数据进行处理。</p>

<h2 id="steaming-processing">Steaming Processing</h2>

<p>所谓的流处理是 Steaming Processing 的翻译，相对于基于 Haddop 的批处理(Batch Processing)，流式处理对应的数据是没有开始结束一直产生的实时数据，就像是河里的水一样，所以翻译为流处理。</p>

<p>传统的批处理中，数据需要落地在存储(HDFS等)中，再通过 Hadoop MapReduce、Hive 或者 Spark 等方式进行处理。但是这种模型在一些特定场景不适用，
例如统计实时的用户行为数据来推荐广告，或者在安全或者业务中需要0延时的对数据进行实时的监控分析并告警，
以及一些数据分析场景需要将正在发生的事统计出报表用于展示。</p>

<p>流处理的发展由一开始的单机数据库+内存处理，到2000-2010年间的基于<a href="https://en.wikipedia.org/wiki/Complex_event_processing">CEP 模型</a>的商业软件(如<a href="https://www.ibm.com/security/security-intelligence/qradar">IBM qradar</a>, 以及开源的 <a href="https://github.com/espertechinc/esper">esper</a> )等，该阶段的流处理引擎的功能基本和今日类似，但没有解决错误容忍、横向扩容以及模型自定义等问题。</p>

<p>后来开源社区中出现了 Storm 和 Spark Streaming 等框架，后来有了 Flink(三者的对比可以参考medium上的这篇<a href="https://medium.com/@chandanbaranwal/spark-streaming-vs-flink-vs-storm-vs-kafka-streams-vs-samza-choose-your-stream-processing-91ea3f04675b">文章</a>)。</p>

<p>其中 Spark Streaming 使用的是 Micro-batching，即将指定窗口大小的事件缓存，再利用批处理的逻辑去处理。这在实时性要求不那么高的统计等场景下比较适用，但是满足不了安全业务中对时间和事件的准确性要求。</p>

<p>Storm 是早期最流行的流处理框架，但是其不支持聚合、窗口等高级特性，而且也没有简单易用的 api 而是需要自己构建拓扑(2.0 版本支持 SQL)，并且对流事件只能保证 at least once 即至少处理一次(不适应安全告警等场景)。</p>

<p>而 Flink 支持 SQL 并且可以方便的进行 UDF 开发，同时社区自带 CEP 库。</p>

<p>关于 Flink 的开发模型可以参考其<a href="https://ci.apache.org/projects/flink/flink-docs-release-1.8/concepts/programming-model.html">文档</a>。</p>

<p>以下的 Demo 项目代码均在 Github <a href="https://github.com/Mithrilwoodrat/seven-weapons-of-data-analysis/tree/master/flink">seven-weapons-of-data-analysis</a>。</p>

<h2 id="flink">Flink</h2>

<p>根据 Flink <a href="https://ci.apache.org/projects/flink/flink-docs-release-1.7/concepts/programming-model.html">文档</a> 中的描述， 
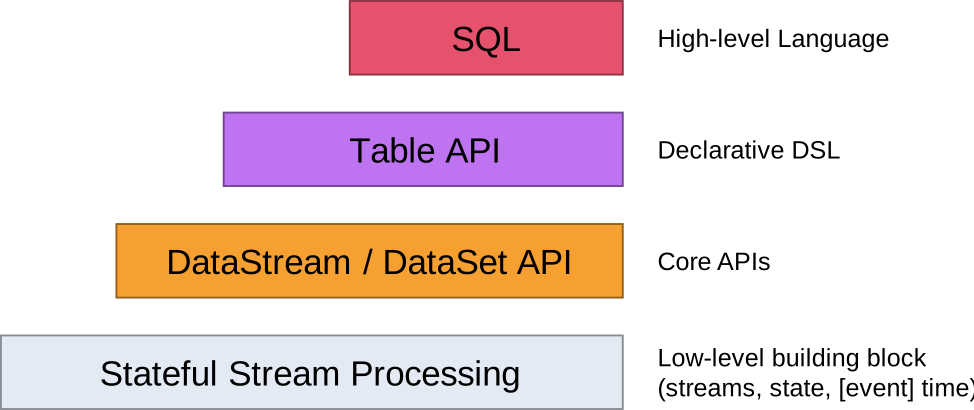
Flink 将流式处理做了如下抽下抽象：</p>

<p><img src="/imgs/seven-weapons-of-data-analysis/levels_of_abstraction.svg" alt="" /></p>

<p>最底层是对流事件的状态化处理，在这之上为对有状态的事件通过统一的 API(DataSteam API)进行处理。 Table API 则是对 DataSteam API 进行封装，提供类 SQL 的 DSL ，最上层的 Flink SQL 则是可以脱离 Java、Scala 等语言，直接通过编写 SQL 进行流处理逻辑的开发。</p>

<h2 id="datastream-demo">DataStream Demo</h2>

<p>根据<a href="https://ci.apache.org/projects/flink/flink-docs-release-1.8/tutorials/datastream_api.html">教程</a>，创建 demo project</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>$ mvn archetype:generate \
    -DarchetypeGroupId=org.apache.flink \
    -DarchetypeArtifactId=flink-quickstart-java \
    -DarchetypeVersion=1.8.0 \
    -DgroupId=wiki-edits \
    -DartifactId=wiki-edits \
    -Dversion=0.1 \
    -Dpackage=wikiedits \
    -DinteractiveMode=false
</code></pre></div></div>

<p>其主要代码如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>package wikiedits;

import org.apache.flink.api.common.functions.FoldFunction;
import org.apache.flink.api.java.functions.KeySelector;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.KeyedStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.streaming.connectors.wikiedits.WikipediaEditEvent;
import org.apache.flink.streaming.connectors.wikiedits.WikipediaEditsSource;

public class WikipediaAnalysis {

  public static void main(String[] args) throws Exception {

    StreamExecutionEnvironment see = StreamExecutionEnvironment.getExecutionEnvironment();

    DataStream&lt;WikipediaEditEvent&gt; edits = see.addSource(new WikipediaEditsSource());

    KeyedStream&lt;WikipediaEditEvent, String&gt; keyedEdits = edits
      .keyBy(new KeySelector&lt;WikipediaEditEvent, String&gt;() {
        @Override
        public String getKey(WikipediaEditEvent event) {
          return event.getUser();
        }
      });

    DataStream&lt;Tuple2&lt;String, Long&gt;&gt; result = keyedEdits
      .timeWindow(Time.seconds(5))
      .fold(new Tuple2&lt;&gt;("", 0L), new FoldFunction&lt;WikipediaEditEvent, Tuple2&lt;String, Long&gt;&gt;() {
        @Override
        public Tuple2&lt;String, Long&gt; fold(Tuple2&lt;String, Long&gt; acc, WikipediaEditEvent event) {
          acc.f0 = event.getUser();
          acc.f1 += event.getByteDiff();
          return acc;
        }
      });

    result.print();

    see.execute();
  }
}
</code></pre></div></div>

<p>WikipediaEditsSource <a href="https://github.com/apache/flink/blob/release-1.8/flink-contrib/flink-connector-wikiedits/src/main/java/org/apache/flink/streaming/connectors/wikiedits/WikipediaEditsSource.java">代码</a> 中，继承了 flink 的 <code class="language-plaintext highlighter-rouge">RichSourceFunction</code> ，通过 IRC 爬取 wikipedia IRC 频道中的消息，处理为格式化的 Event(WikipediaEditEvent)，推送到 DataStream 中。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>public class WikipediaEditsSource extends RichSourceFunction&lt;WikipediaEditEvent&gt; {
  ....
  @Override
	public void run(SourceContext&lt;WikipediaEditEvent&gt; ctx) throws Exception {
		try (WikipediaEditEventIrcStream ircStream = new WikipediaEditEventIrcStream(host, port)) {
			// Open connection and join channel
			ircStream.connect();
			ircStream.join(channel);

			try {
				while (isRunning) {
					// Query for the next edit event
					WikipediaEditEvent edit = ircStream.getEdits().poll(100, TimeUnit.MILLISECONDS);

					if (edit != null) {
						ctx.collect(edit);
					}
				}
			} finally {
				ircStream.leave(channel);
			}
		}
	}
}
</code></pre></div></div>

<p>主要的事件处理逻辑位于 WikipediaAnalysis 的 main 函数中，通过 KeySelector 选择 Event 中的 username 作为 groupby 的 key，KeyedStream。</p>

<p>在 KeyedStream 的基础上，开辟5s一个的时间窗口,并将相同用户的发言字节数相加。</p>

<p>在新的 flink-1.8 中 可以换成下面的写法,类似批处理中的 map reduce 写法可能更容易理解。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>DataStream&lt;WikiUserCount&gt; result = edits
              .map(new MapFunction&lt;WikipediaEditEvent, WikiUserCount&gt;() {
                  @Override
                  public WikiUserCount map(WikipediaEditEvent e) throws Exception {
                      return new WikiUserCount(e.getUser(), e.getByteDiff());
                  }
              })
              .keyBy("user")
              .timeWindow(Time.seconds(5))
              .reduce( new ReduceFunction&lt;WikiUserCount&gt;() {
                  @Override
                  public WikiUserCount reduce(WikiUserCount a, WikiUserCount b) {
                      return new WikiUserCount(a.user, a.count + b.count);
                  }
              });
</code></pre></div></div>

<p>使用下面的命令编译、运行</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mvn clean package
mvn exec:java -Dexec.mainClass=wikiedits.WikipediaAnalysis
</code></pre></div></div>

<p>输出的结果如下</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>2&gt; Aaryangupta23 : -7
4&gt; Wiki13565 : -6
4&gt; Community Tech bot : 0
3&gt; Joeykai : 35
1&gt; EnterpriseyBot : -273
1&gt; Db135 : -22
1&gt; DeltaQuadBot : 414
1&gt; DevGeekStar : 4
1&gt; Joel David 99 : -111
1&gt; Taumata994 : 1091
</code></pre></div></div>

<h2 id="sql-demo">SQL Demo</h2>

<p>根据<a href="https://ci.apache.org/projects/flink/flink-docs-release-1.7/dev/table/common.html">文档</a>，
Flink SQL 和 Table API 都是将一个 DataSteam 即事件流抽象为 table 的概念，table 中的数据为一个个的事件，就类似数据库中的一条条数据。
通过 SQL 或者 DSL 对这些数据进行查询和分析。</p>

<p>使用 SQL 处理和上面一样的事件的核心代码如下(完整代码位于 <a href="https://github.com/Mithrilwoodrat/seven-weapons-of-data-analysis/blob/master/flink/sqldemo/src/main/java/sqldemo/FlinkSQLDemo.java">Github seven-weapons-of-data-analysis</a>):</p>

<p>首先需要初始化流处理环境，为了方便调试，可以使用 <code class="language-plaintext highlighter-rouge">LocalEnvironment</code>。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>StreamExecutionEnvironment env = StreamExecutionEnvironment.createLocalEnvironment();
env.setParallelism(1);
</code></pre></div></div>

<p>然后需要初始化输入事件源的 Source Datastream，以及注册使用 SQL 需要的 TableEnvironment</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>DataStream&lt;WikipediaEditEvent&gt; edits = env.addSource(new WikipediaEditsSource());
StreamTableEnvironment tableEnv = TableEnvironment.getTableEnvironment(env);
</code></pre></div></div>

<p>流式处理中有一个非常重要的数据即为每个事件的事件戳，Flink 需要事件的时间戳来处理基于时间窗口的统计。</p>

<p>Flink 中支持3种不同的时间戳: event time, processing time, and ingestion time。具体的区别可以参考其<a href="https://ci.apache.org/projects/flink/flink-docs-stable/dev/event_timestamps_watermarks.html">文档</a>。</p>

<p>要使用事件时间来做处理，需要在环境中进行设置。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>env.setStreamTimeCharacteristic(TimeCharacteristic.EventTime);
</code></pre></div></div>

<p>可以使用 Timestamp assigners 动态地给原来的 DataSteam 中的每个事件附上时间戳，并生成新的 Datasteam。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>DataStream&lt;WikiUserCount&gt; dataset = edits
        .map(new MapFunction&lt;WikipediaEditEvent, WikiUserCount&gt;() {
            @Override
            public WikiUserCount map(WikipediaEditEvent e) throws Exception {
                return new WikiUserCount(e.getUser(), e.getByteDiff(), e.getTimestamp());
            }
        }).assignTimestampsAndWatermarks(extractor);
</code></pre></div></div>

<p>extractor 简单实现如下，直接返回事件中的 timestamp 字段。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>private final static AscendingTimestampExtractor extractor = new AscendingTimestampExtractor&lt;WikiUserCount&gt;() {
        @Override
        public long extractAscendingTimestamp(WikiUserCount element) {
            return element.timestamp;
        }
    };
</code></pre></div></div>

<p>进行了上面这些准备后，可以将 DataStream 注册为 table，将事件的字段绑定到表的字段上。然后就可以进行 SQL 查询了。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>// Register it so we can use it in SQL
tableEnv.registerDataStream("sensors", dataset, "user, wordcount, timestamp, proctime.proctime");

String query = "SELECT user, SUM(wordcount) AS total,  TUMBLE_END(proctime, INTERVAL '10' SECOND) FROM sensors GROUP BY TUMBLE(proctime, INTERVAL '10' SECOND), user";
Table table = tableEnv.sqlQuery(query); // https://flink.sojb.cn/dev/table/sql.html 1.7 中修改为 .sqlQuery
</code></pre></div></div>

<p>查询的结果为一个新的 table，可以将该 table 转换回 DataSteam 并打印</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>// convert to datastream https://ci.apache.org/projects/flink/flink-docs-release-1.7/dev/table/common.html#integration-with-datastream-and-dataset-api

TupleTypeInfo&lt;Tuple3&lt;String, Integer, Timestamp&gt;&gt; tupleType = new TupleTypeInfo&lt;&gt;(
        Types.STRING(),
        Types.INT(),
        Types.SQL_TIMESTAMP());

DataStream&lt;Tuple3&lt;String, Integer, Timestamp&gt;&gt; dsTuple =
        tableEnv.toAppendStream(table, tupleType);

dsTuple.print();
</code></pre></div></div>

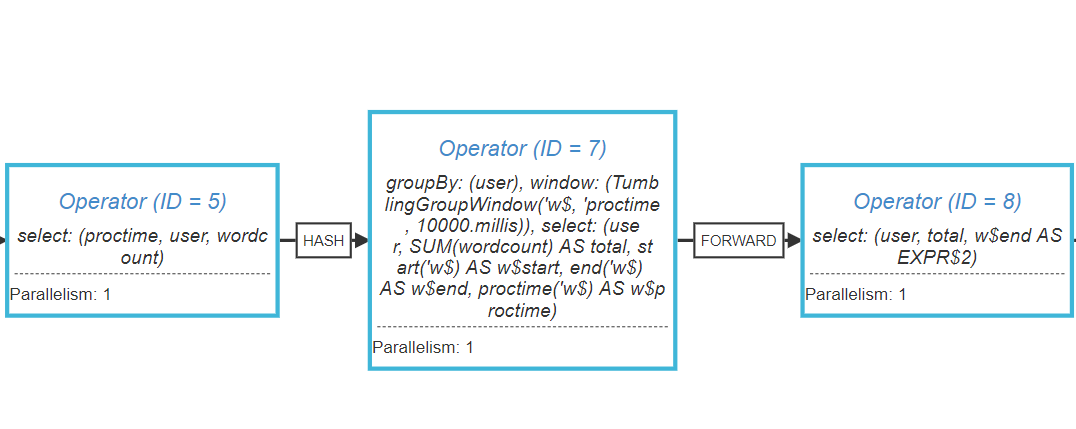
<p>SQL 查询会转换为对应的执行计划，即 DAG 和具体的 DataStream 操作参考<a href="https://ci.apache.org/projects/flink/flink-docs-release-1.7/dev/table/common.html#translate-and-execute-a-query">文档</a>，可以使用 <code class="language-plaintext highlighter-rouge">getExecutionPlan</code> 得到执行计划的 json 表示，
将其提交到 <a href="https://flink.apache.org/visualizer/">flink visualizer 页面</a>上即可查看可视化的执行计划。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>System.out.println(env.getExecutionPlan());
</code></pre></div></div>

<p>该任务的 plan 如下</p>

<p><img src="/imgs/seven-weapons-of-data-analysis/plan.png" alt="" /></p>

<p>可以看到 plan 生成的结果和 DataSteam Demo 中的逻辑基本一致。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>.keyBy("user")
.timeWindow(Time.seconds(5))
.reduce( new ReduceFunction&lt;WikiUserCount&gt;() {
    @Override
    public WikiUserCount reduce(WikiUserCount a, WikiUserCount b) {
        return new WikiUserCount(a.user, a.count + b.count);
    }
});
</code></pre></div></div>

<p>因为查询计划为惰性求值，当调用 execute 时才会被执行。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>//stream.print();
env.execute("print job");
</code></pre></div></div>

<p>执行上述程序得到得结果如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>(DudleyNY,94,2019-08-29 16:12:50.0)
(BrownHairedGirl,-5,2019-08-29 16:12:50.0)
(DemonDays64,1,2019-08-29 16:13:00.0)
(Ravensfire,818,2019-08-29 16:13:00.0)
(SJM2106,91,2019-08-29 16:13:10.0)
(TheSLEEVEmonkey,-37554,2019-08-29 16:13:10.0)
</code></pre></div></div>

<h2 id="集群环境搭建">集群环境搭建</h2>

<p>从 <a href="https://hub.docker.com/_/flink">Dockerhub</a> 拉取最新的 flink 镜像。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>docker pull flink
</code></pre></div></div>

<p>然后编写 <code class="language-plaintext highlighter-rouge">docker-compose.yml</code> 如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>version: "2.1"
services:
  jobmanager:
    image: ${FLINK_DOCKER_IMAGE_NAME:-flink}
    expose:
      - "6123"
    ports:
      - "8081:8081"
    command: jobmanager
    environment:
      - JOB_MANAGER_RPC_ADDRESS=jobmanager

  taskmanager:
    image: ${FLINK_DOCKER_IMAGE_NAME:-flink}
    expose:
      - "6121"
      - "6122"
    depends_on:
      - jobmanager
    command: taskmanager
    links:
      - "jobmanager:jobmanager"
    environment:
      - JOB_MANAGER_RPC_ADDRESS=jobmanager
</code></pre></div></div>

<p>使用 docker-compose 同时启动 jobmanager 和 taskmanager。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>docker-compose up
</code></pre></div></div>

<p>服务暴露的端口如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>The Web Client is on port 8081
JobManager RPC port 6123
TaskManagers RPC port 6122
TaskManagers Data port 6121
</code></pre></div></div>

<h2 id="refs">refs</h2>

<p>https://medium.com/@mustafaakin/flink-streaming-sql-example-6076c1bc91c1
https://gist.github.com/mustafaakin/457859b8bf703c64029071c1139b593d</p>]]></content><author><name>admin</name></author><category term="数据分析" /><summary type="html"><![CDATA[Flink 是一个开源分布式流式处理引擎，支持将数据分发到多个节点，并提供容错机制(fault tolerance)，可以分布式的对流式数据进行处理。]]></summary></entry><entry><title type="html">Golang日期处理</title><link href="/2019/06/17/Golang%E6%97%A5%E6%9C%9F%E5%A4%84%E7%90%86/" rel="alternate" type="text/html" title="Golang日期处理" /><published>2019-06-17T00:00:00+00:00</published><updated>2019-06-17T00:00:00+00:00</updated><id>/2019/06/17/Golang%E6%97%A5%E6%9C%9F%E5%A4%84%E7%90%86</id><content type="html" xml:base="/2019/06/17/Golang%E6%97%A5%E6%9C%9F%E5%A4%84%E7%90%86/"><![CDATA[<h3 id="格式化日期字符串">格式化日期字符串</h3>

<p>https://stackoverflow.com/questions/20234104/how-to-format-current-time-using-a-yyyymmddhhmmss-format</p>

<p>Golang 中的时间字符串格式化和 C/C++ 以及 Python 等语言中不同，它没有 strftime 函数。
参考其<a href="https://golang.org/pkg/time/#Time.Format">官方文档</a>，它使用模板(layout)来定义格式化和解析时间字符串的格式。</p>

<p>根据其源码中的注释，<a href="https://golang.org/src/time/format.go">https://golang.org/src/time/format.go</a></p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>// These are predefined layouts for use in Time.Format and time.Parse.
// The reference time used in the layouts is the specific time:
//	Mon Jan 2 15:04:05 MST 2006
// which is Unix time 1136239445. Since MST is GMT-0700,
// the reference time can be thought of as
//	01/02 03:04:05PM '06 -0700
</code></pre></div></div>

<p>要自定义时间格式，只用按 2006年1月2日3点(15点)4分5秒 这个时间来变换来组合即可。其中可以0来补齐位数，也可以使用 <code class="language-plaintext highlighter-rouge">_</code> 来表示使用空格对齐某个字段。</p>

<p>例如在有 strftime 的语言中(例如 Python 中)，获取当前的时间戳并格式如下</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>import datetime.datetime

n  = datetime.datetime.now()
n.strftime("%Y-%m-%d %H:%M:%S")

# Out '2019-06-17 16:47:26'
</code></pre></div></div>

<p>在 Golang 中，按照上面的规定，layout 如下</p>

<p><a href="https://play.golang.org/p/eOR9YF_kVM9">https://play.golang.org/p/eOR9YF_kVM9</a></p>
<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>package main

import (
	"fmt"
	"time"
)

func main() {
	t := time.Now()
	layout := "2006-01-02 15:04:05"
	fmt.Println(t.Format(layout))
}
</code></pre></div></div>

<p>但要格式化成例如 “20190617” 这样的字符串时，使用 layout 会产生歧义无法得到想要的结果，
这时就需要获取日期的年、月、日字段后直接格式化字符串了。这种情况下 strftime 还是更加通用一些。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>date := fmt.Sprintf("%d%02d%02d",
		t.Year(), t.Month(), t.Day())
fmt.Println(date)
</code></pre></div></div>

<h3 id="时间比较">时间比较</h3>

<p>Golang 中的 time package 源码位于 https://golang.org/src/time/time.go，
使用前大致浏览一下源码有助于更好的使用。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>type Time struct {
	// wall and ext encode the wall time seconds, wall time nanoseconds,
	// and optional monotonic clock reading in nanoseconds.
	//
	// From high to low bit position, wall encodes a 1-bit flag (hasMonotonic),
	// a 33-bit seconds field, and a 30-bit wall time nanoseconds field.
	// The nanoseconds field is in the range [0, 999999999].
	// If the hasMonotonic bit is 0, then the 33-bit field must be zero
	// and the full signed 64-bit wall seconds since Jan 1 year 1 is stored in ext.
	// If the hasMonotonic bit is 1, then the 33-bit field holds a 33-bit
	// unsigned wall seconds since Jan 1 year 1885, and ext holds a
	// signed 64-bit monotonic clock reading, nanoseconds since process start.
	wall uint64
	ext  int64

	// loc specifies the Location that should be used to
	// determine the minute, hour, month, day, and year
	// that correspond to this Time.
	// The nil location means UTC.
	// All UTC times are represented with loc==nil, never loc==&amp;utcLoc.
	loc *Location
}

const (
	hasMonotonic = 1 &lt;&lt; 63
	maxWall      = wallToInternal + (1&lt;&lt;33 - 1) // year 2157
	minWall      = wallToInternal               // year 1885
	nsecMask     = 1&lt;&lt;30 - 1
	nsecShift    = 30
)
</code></pre></div></div>

<p>因为 Golang 中不支持函数重载和运算符重载，时间的比较需要显示调用 Before、Equal、After 等函数来判断。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>// sec returns the time's seconds since Jan 1 year 1.
func (t *Time) sec() int64 {
	if t.wall&amp;hasMonotonic != 0 {
		return wallToInternal + int64(t.wall&lt;&lt;1&gt;&gt;(nsecShift+1))
	}
	return t.ext
}

func (t Time) After(u Time) bool {
	if t.wall&amp;u.wall&amp;hasMonotonic != 0 {
		return t.ext &gt; u.ext
	}
	ts := t.sec()
	us := u.sec()
	return ts &gt; us || ts == us &amp;&amp; t.nsec() &gt; u.nsec()
}
</code></pre></div></div>

<h3 id="时区处理">时区处理</h3>

<p>从 mysql 的 datetime 字段取出的数据一般为 “2019-09-24 18:00:00” 格式，其隐含有时区为东八区的信息。</p>

<p>而 t.Unix() 函数会忽略时区信息，统一按 UTC 时间处理。所以生成 unix 时间戳的时候需要注意。</p>

<p>示例代码如下</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>package main

import (
	"fmt"
	"time"
)

func main() {
	datetimeLayout := "2006-01-02 15:04:05"
	timeStr := "2019-09-24 18:00:00"
	timelocal := time.FixedZone("CST", 3600*8)
	t1, _ := time.Parse(datetimeLayout, timeStr)
	t2, _ := time.ParseInLocation(datetimeLayout, timeStr, timelocal)
	fmt.Println(t1, t1.Unix())
	fmt.Println(t2, t2.UTC(), 2019-09-24 10:00:00, t2.UTC().Unix())
	fmt.Println(time.Unix(t1.Unix(), 0).Format(datetimeLayout))
	fmt.Println(time.Unix(t2.UTC().Unix(), 0).Format(datetimeLayout))
	fmt.Println(time.Unix(t2.UTC().Unix(), 0).In(timelocal).Format(datetimeLayout))
	
}
</code></pre></div></div>

<p>对应 <a href="https://play.golang.org/p/DMq4GMNyABY">playgroud</a> 中运行的结果如下：</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>2019-09-24 18:00:00 +0000 UTC 1569348000
2019-09-24 18:00:00 +0800 CST 2019-09-24 10:00:00 +0000 UTC 1569319200
2019-09-24 18:00:00
2019-09-24 10:00:00
2019-09-24 18:00:00
</code></pre></div></div>

<p>对于时间字符串如果不指定时区调用 Parse 函数，默认是按 UTC 时间解析的，
可以看到第一个输出的结果为 <code class="language-plaintext highlighter-rouge">2019-09-24 18:00:00 +0000 UTC</code>，而北京时间下午六点实际应该对应 <code class="language-plaintext highlighter-rouge">2019-09-24 10:00:00 +0000 UTC</code>。</p>

<p>而使用 ParseInLocation 得到的结果则是正确的。</p>

<p>而转换回unix时间戳时，带时区信息的 time 结构体需要先调用 .UTC() 转换为 Unix 时间，再调用 Unix()，才能得到正确的时间戳。</p>]]></content><author><name>admin</name></author><category term="golang" /><summary type="html"><![CDATA[格式化日期字符串]]></summary></entry><entry><title type="html">Golang踩坑总结</title><link href="/2019/06/17/golang%E8%B8%A9%E5%9D%91%E6%80%BB%E7%BB%93/" rel="alternate" type="text/html" title="Golang踩坑总结" /><published>2019-06-17T00:00:00+00:00</published><updated>2019-06-17T00:00:00+00:00</updated><id>/2019/06/17/Golang%E8%B8%A9%E5%9D%91%E6%80%BB%E7%BB%93</id><content type="html" xml:base="/2019/06/17/golang%E8%B8%A9%E5%9D%91%E6%80%BB%E7%BB%93/"><![CDATA[<h1 id="golang踩坑总结">Golang踩坑总结</h1>

<p>从 15 年起，陆陆续续得写了几年 Go ，但大多都是小工具和一些简单的服务。最近一段时间用 Golang 多了一些，有了一些经验类的东西可以记录和分享。包括下面几点</p>

<ul>
  <li>Golang 项目结构和 Makefile 的组织</li>
  <li>Golang 的依赖管理</li>
  <li>Golang 的调试(使用 dlv 工具)</li>
  <li>Golang 服务的 profile</li>
  <li>CGo 的编写和使用</li>
  <li>Golang 标准库的使用中的常见问题
    <ul>
      <li><a href="/2019/06/17/Golang%E6%97%A5%E6%9C%9F%E5%A4%84%E7%90%86/">Golang 中格式化日期字符串</a></li>
      <li>Golang HTTP Client 的使用和常见问题</li>
    </ul>
  </li>
</ul>

<h2 id="项目结构和-makefile">项目结构和 Makefile</h2>

<p>一个 Golang 工程的典型结构如下， 将 GOPATH 设置为 pwd，编译时可以自动去 <code class="language-plaintext highlighter-rouge">src/&lt;ProjectName&gt;</code> 寻找代码，其他的内部库函数等也可以放到 src 下，并且依赖可以都放到 src/vendor 目录中。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>.
├── LICENSE
├── Makefile
├── README.md
├── bin
├── log
├── conf
│   ├── conf.toml
├── src
│   ├── LibName
│   ├── ProjectName
│   │   └── main.go
│   └── vendor
</code></pre></div></div>

<p>Makefile 中指定 GOPATH 为当前路径，然后将生成的 bin 文件输出到 bin 目录中。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>all: build

GOPATH=${CURDIR}
BINARY=&lt;PackageName&gt;
PackageName=&lt;PackageName&gt;
CONF=./conf/
LOG=./log

.PHONY: build build_linux64 clean package
	
build:
	GOPATH=${GoPATH} go build -o bin/${BINARY} ${PackageName}

build_linux64:
	GOPATH=${GoPATH} GoARCH=amd64 GoOS=linux go build -o bin/${BINARY} ${PackageName}

debug_build: 
	GOARCH=amd64 GoOS=linux go build -a -race -gcflags "all=-N -l" -ldflags '-extldflags "-static"' ${PackageName}

clean:
	rm -f *.tar.gz ${BINARY}
	rm -f *.tar.gz ${LOG}/*

package: build_linux64
	rm -f *.tar.gz ${LOG}/*
	zip ${PackageName}.zip bin/${BINARY} conf/example.conf
</code></pre></div></div>

<h2 id="依赖管理">依赖管理</h2>

<p>旧版本的 go 中可以使用 <a href="https://github.com/FiloSottile/gvt">gvt</a> 工具来管理依赖。
使用 <code class="language-plaintext highlighter-rouge">go get https://github.com/FiloSottile/gvt</code> 安装 gvt。(需要 <code class="language-plaintext highlighter-rouge">export PATH=$PATH:$GOPATH/bin</code>)</p>

<p>然后在根目录下</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>export GOPATH=`pwd` 
</code></pre></div></div>

<p>再到 src 目录下执行 <code class="language-plaintext highlighter-rouge">gvt fetch -precaire &lt;package name&gt;</code></p>

<p>下载的依赖和其版本会记录到 <code class="language-plaintext highlighter-rouge">manifest</code> 文件中，源文件则会存储在 src/vendor 中。</p>

<p>Go 1.11、1.12及后续版本会开始支持 <a href="https://blog.golang.org/using-go-modules">Go Modules</a>。</p>

<p>在已存在的项目中，只需要先</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>cd src/&lt;PackageName&gt;
</code></pre></div></div>

<p>然后执行</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Go111MODULE=on go mod init
</code></pre></div></div>

<p>即可初始化 go module，生成 go.mod 文件。</p>

<p>再执行 <code class="language-plaintext highlighter-rouge">GO111MODULE=on go build ./...</code> 即可自动下载对应的依赖，下载的依赖会存储在 <code class="language-plaintext highlighter-rouge">$GOPATH/pkg/mod</code> 中，
其版本会写入 go.mod 中。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>module MithrilSSHTunnel

require (
        github.com/BurntSushi/toml v0.3.1
        golang.org/x/crypto v0.0.0-20190617133340-57b3e21c3d56
)
</code></pre></div></div>

<h2 id="go-113-project-layout">Go 1.13 project-layout</h2>

<p><a href="https://github.com/golang-standards/project-layout">https://github.com/golang-standards/project-layout</a></p>

<h2 id="cgo">CGo</h2>

<p>Golang 支持和 C 代码交互，可以在 Go 源码中使用特殊的语法编写 C 代码然后一起打包，也可以使 Go 代码和 C 动态链接库通过 ABI 进行交互。参考 https://golang.org/cmd/cgo/。</p>

<h3 id="go-源码中使用-c">Go 源码中使用 C</h3>
<p>Go 源码中使用 C 代码的示例如下</p>

<p>test.go</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>package main

// #include &lt;stdio.h&gt;
// #include &lt;stdlib.h&gt;
// void hello(char * s)
// {
//     printf("%s", s);
// }
import "C"
import "unsafe"

func main() {
        cs := C.CString("Hello World")
        C.hello(cs)
        C.free(unsafe.Pointer(cs))
}
</code></pre></div></div>

<p>go run test.go  即可输出 <code class="language-plaintext highlighter-rouge">Hello World</code>。</p>

<p>使用 <code class="language-plaintext highlighter-rouge">go tool cgo -debug-gcc test.go</code> 可以得到中间代码和对象，在当前目录的 <code class="language-plaintext highlighter-rouge">_obj</code> 目录下。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>$ ls _obj
_cgo_.o         _cgo_export.h   _cgo_gotypes.go test.cgo1.go
_cgo_export.c   _cgo_flags      _cgo_main.c     test.cgo2.c
</code></pre></div></div>

<p>使用 readelf -s 可以看出 go build 编译后的文件中包含 hello 函数的代码和符号。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>readelf -s test |grep hello
    71: 0000000000453630    22 FUNC    GLOBAL DEFAULT   15 hello
  1381: 00000000004533a0   121 FUNC    LOCAL  DEFAULT   15 main._Cfunc_hello
  1459: 0000000000453630    22 FUNC    GLOBAL DEFAULT   15 hello
</code></pre></div></div>

<h3 id="go-链接动态链接库">Go 链接动态链接库</h3>

<p>在上面的 test.go 中，使用了 <code class="language-plaintext highlighter-rouge">stdlib.h</code>, <code class="language-plaintext highlighter-rouge">stdio.h</code> 等头文件，并使用了其中的 printf 和 free 函数，C 的标准库函数在 Linux 上位于 glibc 中，go 编译出的文件会通过 ABI 来调用。</p>

<p>例如 free 函数，使用 readelf 查看符号可以看到 test 文件中引用了 GLIBC 中的 free 符号。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>1380: 0000000000453320   121 FUNC    LOCAL  DEFAULT   15 main._Cfunc_free
1426: 0000000000000000     0 FUNC    GLOBAL DEFAULT  UND free@@GLIBC_2.2.5
</code></pre></div></div>

<p>除了和系统自带的 so 交互外，用户也可以将自己或第三方的 C 库和 Go 一起编译打包部署,即在 Makefile 中先编译 C 代码为 so 与 Go 的 bin 文件一起发布。</p>

<h2 id="使用-dlv-调试-go-代码">使用 dlv 调试 Go 代码</h2>

<p>在 Linux 上，Golang 虽然也是编译成 ELF 文件运行，但因为 Go 有其独特的运行时和调试信息，直接使用 GDB 调试有很多功能受限，具体可以参考 https://golang.org/doc/gdb 。</p>

<p>由于上面的原因， Golang 团队开发了一个专门用于 Go 语言调试的工具，<a href="https://github.com/go-delve/delve">delve</a>。</p>

<h3 id="安装">安装</h3>
<p>dlv 的安装很简单，使用 <code class="language-plaintext highlighter-rouge">go get -u github.com/go-delve/delve/cmd/dlv</code> 并保证 <code class="language-plaintext highlighter-rouge">$GoPATH/bin</code> 在 <code class="language-plaintext highlighter-rouge">$PATH</code> 中即可。</p>

<h3 id="命令行">命令行</h3>

<ul>
  <li>使用 <code class="language-plaintext highlighter-rouge">dlv attach &lt;pid&gt;</code> attach 到一个已在运行的 go 进程中。</li>
  <li>使用 <code class="language-plaintext highlighter-rouge">dlv exec &lt;path&gt;</code> 拉起要 debug 的程序。</li>
</ul>

<h3 id="vars">Vars</h3>

<p>vars 支持正则查找变量</p>

<p>vars –v 查看详情</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>(dlv) vars  &lt;ProjectName&gt;/&lt;PackagetName&gt;.&lt;VarName&gt;
</code></pre></div></div>

<p>Vars 不能查看结构体内容</p>

<h3 id="print">print</h3>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>(dlv) print  "&lt;ProjectName&gt;r/&lt;PackagetName&gt;".&lt;VarName&gt;.&lt;StructField&gt; 

*sync.Map { 

        mu: sync.Mutex {state: 0, sema: 0}, 

        read: sync/atomic.Value { 

                v: interface {}(sync.readOnly) *(*interface {})(0xc42007f4a8),}, 

        dirty: map[interface {}]*sync.entry [ 

                *(*interface {})(0xc470b30008): *(*sync.entry)(0xc4200960e0), 

                *(*interface {})(0xc470b30018): *(*sync.entry)(0xc420096110), 

                *(*interface {})(0xc470b30028): *(*sync.entry)(0xc420096120), 

                *(*interface {})(0xc470b30038): *(*sync.entry)(0xc420096130), 

                *(*interface {})(0xc470b30048): *(*sync.entry)(0xc420096148), 

                *(*interface {})(0xc470b30058): *(*sync.entry)(0xc420096168), 

                *(*interface {})(0xc470b300d8): *(*sync.entry)(0xc4200960d8), 

                *(*interface {})(0xc470b300e8): *(*sync.entry)(0xc4200960e8), 

                *(*interface {})(0xc470b300f8): *(*sync.entry)(0xc420096108), 

                *(*interface {})(0xc470b30108): *(*sync.entry)(0xc420096138), 

                *(*interface {})(0xc470b30118): *(*sync.entry)(0xc420096158), 

        ], 

        misses: 0,} 
</code></pre></div></div>

<p>Print 可以支持包路径，并且查看包中结构体等变量的内容。</p>

<p>如 sync map 可以使用 .dirty 查看内容</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>
(dlv) print  "&lt;ProjectName&gt;r/&lt;PackagetName&gt;".&lt;VarName&gt;.&lt;StructField&gt;.dirty 

map[interface {}]*sync.entry [ 
        "baidu.com": *{p: unsafe.Pointer(0xc470b34410)}
] 

</code></pre></div></div>

<h2 id="set-breakpoints">Set breakpoints</h2>

<p><code class="language-plaintext highlighter-rouge">b "&lt;ProjectName&gt;r/&lt;PackagetName&gt;".&lt;VarName&gt;</code></p>

<h3 id="set-break-in-struct-function">set break in struct function</h3>

<p><code class="language-plaintext highlighter-rouge">&lt;ProjectName&gt;/&lt;PackagetName&gt;".(*&lt;StructName&gt;).&lt;FunctionName&gt;</code></p>

<h2 id="golang-服务的-profile">Golang 服务的 profile</h2>

<p>Go 提供了 profile 工具，可以很方便的对已经编写好的 Go 服务程序进行 profile。参考 <a href="https://blog.golang.org/profiling-go-programs">https://blog.golang.org/profiling-go-programs</a>。</p>

<p>只需要在代码中添加几个 http 接口，即可在服务运行中拿到实时的性能数据，并且对服务本身的性能影响可以忽略不计。</p>

<p>参考 <a href="https://artem.krylysov.com/blog/2017/03/13/profiling-and-optimizing-go-web-applications/">https://artem.krylysov.com/blog/2017/03/13/profiling-and-optimizing-go-web-applications/</a></p>

<p>添加如下的 http 接口：</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>DEBUG PROFILE
http.HandleFunc("/api/v1/debug/pprof/", pprof.Index)
http.HandleFunc("/api/v1/debug/pprof/cmdline", pprof.Cmdline)
http.HandleFunc("/api/v1/debug/pprof/profile", pprof.Profile)
http.HandleFunc("/api/v1/debug/pprof/symbol", pprof.Symbol)
http.HandleFunc("/api/v1/debug/pprof/trace", pprof.Trace)
http.HandleFunc("/api/test/",enforceJSONHandler(sadata.))
</code></pre></div></div>

<p>使用 apache bench 对业务接口进行压力测试，同时在本地使用 <code class="language-plaintext highlighter-rouge">go tool pprof http://&lt;remoteip&gt;:&lt;remote_port&gt;/api/v1/debug/pprof/profile</code> 即可链接上远程的 profile 接口，拉取 profile 信息。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>ab -k  -p body.txt -T application/json -c 1000 -n 20000 http://&lt;host/api/v1/
</code></pre></div></div>

<p>在 <code class="language-plaintext highlighter-rouge">pprof</code> 命令行中使用 <code class="language-plaintext highlighter-rouge">top</code> 命令可以查看 cpu 使用占比，使用 <code class="language-plaintext highlighter-rouge">web</code> 命令则会生成 svg 调用图，可以很方便的分析性能瓶颈。</p>

<h2 id="golang-标准库的使用中的常见问题">Golang 标准库的使用中的常见问题</h2>

<h3 id="golang-http-client-的使用和常见问题">Golang HTTP Client 的使用和常见问题</h3>

<p>在使用 Go 标准的 “net/http” 库中的 http client 时，可以自定义 http client 的参数，默认的 DefaultClient 没有超时时间。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>HTTPClient = &amp;http.Client{
  Transport: &amp;http.Transport{
    DialContext: (&amp;net.Dialer{
      Timeout:   10 * time.Second,
      KeepAlive: 30 * time.Second,
    }).DialContext,
    TLSHandshakeTimeout: 10 * time.Second,
    MaxIdleConns:        1000,
    MaxIdleConnsPerHost: 1000,
    IdleConnTimeout:     time.Duration(90) * time.Second,
  },
  Timeout: 2 * time.Second,
}
</code></pre></div></div>

<p>使用 http client 发送 post 请求并解析返回的 json 示例代码如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>func DoPost(url string) (map[string]interface{}, error) {
  req := make(map[string]interface{})
  body := make(map[string]interface{})
	req_body, _ := json.Marshal(req)
	reader := bytes.NewReader(req_body)
	resp, err := HTTPClient.Post(url, "Content-Type: Application/json", reader)
	if err != nil {
		fmt.Printf("http req error %s", err.Error())
		return body, err
	}
	if resp.StatusCode != 200 {
		mess := fmt.Sprintf("http status %d", resp.StatusCode)
		return body, errors.New(mess)
	}
	defer resp.Body.Close()
	respBody, err := ioutil.ReadAll(resp.Body)

	if err != nil {
		mess := fmt.Sprintf("Read body error %s", err.Error())
		logdef.LogError(mess)
		return body, errors.New(mess)
  }
  
	err = json.Unmarshal(respBody, &amp;body)
	if err != nil {
		mess := fmt.Sprintf("Json parse error %s", err.Error())
		return body, errors.New(mess)
  }
  return body, nil
}
</code></pre></div></div>

<p>使用 http client 下载数据时，需要注意服务器有没有开启 gzip 压缩功能，如果开启了 gzip 压缩，则返回的 http respsone 中可能是分块传输的，不会有 Content-Length 字段，这时读取 <code class="language-plaintext highlighter-rouge">Get</code> 返回的 <code class="language-plaintext highlighter-rouge">Response</code> 中的 <code class="language-plaintext highlighter-rouge">ContentLength</code> 会返回 -1。</p>

<p>参考 <a href="https://zh.wikipedia.org/wiki/%E5%88%86%E5%9D%97%E4%BC%A0%E8%BE%93%E7%BC%96%E7%A0%81">wiki</a>，返回的 HTTP Response 头如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>HTTP/1.1 200 OK
Content-Type: text/plain
Transfer-Encoding: chunked
</code></pre></div></div>

<p>下载文件时，服务器可能会返回文件名，位于 Response Header 的 <code class="language-plaintext highlighter-rouge">Content-Disposition</code> 字段中，例如 <code class="language-plaintext highlighter-rouge">Content-Disposition: attachment; filename="filename.jpg"</code>。具体的定义可以参考 <a href="https://developer.mozilla.org/en-US/docs/Web/HTTP/Headers/Content-Disposition">MDN</a></p>

<p>处理这种情况的示例代码如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>func HttpReqFile(url string, downloadPath string) (string, error) {
	resp, err := http.Get(url)
	if err != nil {
		return "", err
	}
	if resp.StatusCode != 200 {
		return "", err
	}
	defer resp.Body.Close()

	length := resp.ContentLength
	logdef.LogInfof("rsp length:%v", length)
	encryContent := new(ServerReplayAll)

	filename := "DefaultFileName"
	filepath := fmt.Sprintf("%s%s", downloadPath, filename)

	ContentDisposition := resp.Header.Get("Content-Disposition")
	if len(ContentDisposition) &gt; 0 {
		_, params, err := mime.ParseMediaType(ContentDisposition)
		if err != nil {
			fmt.Println("Parse Content-Disposition Failed")
		} else {
			if filename, ok := params["filename"]; ok {
				filepath = fmt.Sprintf("%s%s", downloadPath, filename)
			} else {
				fmt.Println("Parse Content-Disposition Failed No FileName")
			}
		}
	}

	if length &gt; 0 {
		respBody := make([]byte, length, length)
		n, err := io.ReadFull(resp.Body, respBody)
		if err != nil {
			return "", err
		}
		if ioutil.WriteFile(filepath, respBody, 0644) == nil {
			fmt.Println("wirte success ", filepath)
		} else {
			fmt.Println("wirte failure ", filepath)
			filepath = ""
		}
	} else if length == -1 {
		fmt.Println("resp.ContentLength is Unkown(-1)")
		out, err := os.Create(filepath)
		if err != nil {
			fmt.Printf("create file failure %v: err:%v", filepath, err)
			filepath = ""
		}
		defer out.Close()
		wlen, err := io.Copy(out, resp.Body)
		if err != nil {
			fmt.Printf("wirte failure ", filepath)
			filepath = ""
		}
		fmt.Printf("Write FIle Length:%v", wlen)
	} else if length == 0 {
		fmt.Println("resp.ContentLength is 0!")
		return "", errors.New("ContentLength is 0")
  }
  return filepath, nil
}
</code></pre></div></div>

<p>还有一个问题是，HTTPClient 设置了 Transport 配置后，不会读取默认的环境遍历中的代理配置。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>type Transport struct {
	// Proxy specifies a function to return a proxy for a given
	// Request. If the function returns a non-nil error, the
	// request is aborted with the provided error.
	//
	// The proxy type is determined by the URL scheme. "http",
	// "https", and "socks5" are supported. If the scheme is empty,
	// "http" is assumed.
	//
	// If Proxy is nil or returns a nil *URL, no proxy is used.
	Proxy func(*Request) (*url.URL, error)
}
</code></pre></div></div>

<p>可以在创建 HTTPClient 时在 Transport 中指定 Proxy 为默认的 http.ProxyFromEnvironment</p>

<p>HTTPClient = &amp;http.Client{
	Transport: &amp;http.Transport{
		Proxy: http.ProxyFromEnvironment,
	},
	Timeout: time.Duration(5 * time.Second),
}</p>

<h3 id="golang-http-client-multipartform-data-上传文件">Golang HTTP Client multipart/form-data 上传文件</h3>

<p>使用 <code class="language-plaintext highlighter-rouge">multipart.NewWriter</code> 来创建表单数据, <code class="language-plaintext highlighter-rouge">NewWriter</code> 会随机创建一个 Boundary，浏览器中会自动创建这个字段。如果要指定 Boundary 则需要在创建 <code class="language-plaintext highlighter-rouge">NewWriter</code> 后调用 SetBoundary。</p>

<p><code class="language-plaintext highlighter-rouge">CreateFormFile</code> 函数封装了 <code class="language-plaintext highlighter-rouge">CreatePart</code>，会默认创建 <code class="language-plaintext highlighter-rouge">"Content-Type", "application/octet-stream"</code> 的 form data。</p>

<p>发送 POST 请求前，需要使用 <code class="language-plaintext highlighter-rouge">request.Header.Set("Content-Type", w.FormDataContentType())</code> 设置 Header 的 Content-Type，
这里如果不使用 SetBoundary 则会是随机 <code class="language-plaintext highlighter-rouge">boundary</code>。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>func NewWriter(w io.Writer) *Writer {
	return &amp;Writer{
		w:        w,
		boundary: randomBoundary(),
	}
}
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">NewWriter</code> 需要在发送请求前手动调用 Close，因为最后一个 <code class="language-plaintext highlighter-rouge">boundary</code> 的末尾会多两个横线 <code class="language-plaintext highlighter-rouge">--</code> 来标识结束，会在调用 Close 时添加。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>func uploadFile(fpath string) error {
	var body bytes.Buffer
	w := multipart.NewWriter(&amp;body)
	w.SetBoundary("---011000010111000001101001")
	err := w.WriteField("a", "field_a")
	if err != nil {
		mess := fmt.Sprintf("WriteField error %s", err.Error())
		glog.Error(mess)
		return err
	}

	file, err := os.Open(fpath)

	if err != nil {
		glog.Error(err)
		return err
	}

	defer file.Close()

	h := make(textproto.MIMEHeader)
	h.Set("Content-Disposition",
		fmt.Sprintf(`form-data; name="%s"; filename="%s"`,
			escapeQuotes("image"), escapeQuotes(filepath.Base(file.Name()))))
	h.Set("Content-Type", "image/png")
	part, err := w.CreatePart(h)

	//part, err := w.CreateFormFile("image", filepath.Base(file.Name()))
	if err != nil {
		glog.Error(err)
		return err
	}

	io.Copy(part, file)

	w.Close()

	var uploadRaspBody uploadResp
	request, err := http.NewRequest("POST", uploadAPI, &amp;body)
	if err != nil {
		mess := fmt.Sprintf("Create Request error %s", err.Error())
		glog.Error(mess)
		return err
	}
	//request.Header.Set("Content-Type", "multipart/form-data; boundary=---011000010111000001101001")
	request.Header.Set("Content-Type", w.FormDataContentType())

	resp, err := HTTPClient.Do(request)
	if err != nil {
		mess := fmt.Sprintf("http req error %s", err.Error())
		glog.Error(mess)
		return err
	}
	defer resp.Body.Close()
	respBody, err := ioutil.ReadAll(resp.Body)

	if err != nil {
		mess := fmt.Sprintf("Read body error %s", err.Error())
		glog.Error(mess)
		return errors.New(mess)
	}

	if resp.StatusCode != 200 {
		mess := fmt.Sprintf("http status %d", resp.StatusCode)
		glog.Error("Resp Body : %s", string(respBody))
		glog.Error(mess)
		return errors.New(mess)
	}

	err = json.Unmarshal(respBody, &amp;uploadRaspBody)
	if err != nil {
		mess := fmt.Sprintf("Json parse error %s", err.Error())
		return errors.New(mess)
	}
	fmt.Println(uploadRaspBody)
	return nil
}
</code></pre></div></div>

<p>最后发送的实际请求如下</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>POST /uploadurl/ HTTP/1.1
Host: uploadserver
User-Agent: Go-http-client/1.1
Content-Length: 867216
Content-Type: multipart/form-data; boundary=---011000010111000001101001
Accept-Encoding: gzip

-----011000010111000001101001
Content-Disposition: form-data; name="a"

field_a
-----011000010111000001101001
Content-Disposition: form-data; name="b"

field_b
-----011000010111000001101001
Content-Disposition: form-data; name="image"; filename="test.png"
Content-Type: image/png

PNG
&lt;Content&gt;
-----011000010111000001101001--
</code></pre></div></div>

<p>参考 RFC1867(<a href="https://tools.ietf.org/html/rfc1867">https://tools.ietf.org/html/rfc1867</a>)</p>]]></content><author><name>admin</name></author><category term="golang" /><summary type="html"><![CDATA[Golang踩坑总结]]></summary></entry><entry><title type="html">编译器开发从零单排(3)</title><link href="/2019/05/27/%E7%BC%96%E8%AF%91%E5%99%A8%E5%BC%80%E5%8F%91%E4%BB%8E%E9%9B%B6%E5%8D%95%E6%8E%92(3)/" rel="alternate" type="text/html" title="编译器开发从零单排(3)" /><published>2019-05-27T00:00:00+00:00</published><updated>2019-05-27T00:00:00+00:00</updated><id>/2019/05/27/%E7%BC%96%E8%AF%91%E5%99%A8%E5%BC%80%E5%8F%91%E4%BB%8E%E9%9B%B6%E5%8D%95%E6%8E%92(3)</id><content type="html" xml:base="/2019/05/27/%E7%BC%96%E8%AF%91%E5%99%A8%E5%BC%80%E5%8F%91%E4%BB%8E%E9%9B%B6%E5%8D%95%E6%8E%92(3)/"><![CDATA[<h1 id="naivecompiler-前端设计">NaiveCompiler 前端设计</h1>

<h2 id="语义分析-semantic-analysis">语义分析 (semantic analysis)</h2>

<p>编译器在完成语法分析之后的步骤为语义分析，该步骤会添加语义信息到 Parse Tree 中，并构建符号表(Symbol Table)。</p>

<p>在这个过程中，会同时进行语义检测，例如：类型检查（type checking），以及定义赋值检查（definite assignment analysis）等。</p>

<p>语义分析通常是基于 Parse Tree 或者 AST 进行。 NaiveCompiler 的语义分析实现于 <code class="language-plaintext highlighter-rouge">analysis_handler.py</code> 中。
<code class="language-plaintext highlighter-rouge">analysis_handler.py</code> 中的类继承 <code class="language-plaintext highlighter-rouge">visitor.py</code> 中实现的 visitor 访问模式类 <code class="language-plaintext highlighter-rouge">NodeVisitor</code>，实现对 AST 的访问和分析。</p>

<p>Clang 中的语义分析定义于 <a href="https://code.woboq.org/llvm/clang/lib/Sema/SemaChecking.cpp.html"><code class="language-plaintext highlighter-rouge">SemaChecking.cpp</code></a> 中。同样是通过 Visitor 模式实现。</p>

<h3 id="visitor-模式及其实现">Visitor 模式及其实现</h3>

<p>Visitor 模式是《设计模式》(GoF design patterns)中的 23 个设计模式之一，可以实现算法和实际对象结构的分离，可以在不修改对象结构的情况下给对象添加新的方法。</p>

<p>在 C++ 中可以利用函数重载，double dispatch 来实现 visitor 模式，不需要修改已定义好的 class 源码。而 Python 中则更为简单，通过反射获取类名即可实现。</p>

<p>Visitor 模式还有一个好处，即遍历 AST 时，所有的节点都是继承自 ASTNode，所以可以方便的递归遍历整颗树，并只对感兴趣的节点做处理。</p>

<p>在 NaiveCompiler 的前端中， visitor 都继承自 <code class="language-plaintext highlighter-rouge">visitor.py</code> 中的 <code class="language-plaintext highlighter-rouge">NodeVisitor</code>。该源码修改自 CPython 自身的 <a href="https://github.com/python/cpython/blob/2.7/Lib/ast.py#L217"><code class="language-plaintext highlighter-rouge">NodeVisitor</code></a>(定义于/Lib/ast.py)。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>class NodeVisitor(object):
    def visit(self, node):
        method = 'visit_' + node.__class__.__name__
        visitor = getattr(self, method, self.generic_visit)
        return visitor(node)

    def generic_visit(self, node):
        for c in node.children():
            self.visit(c)
</code></pre></div></div>

<p>要实现特定的功能只需要继承该类，以 <code class="language-plaintext highlighter-rouge">visit_XXX</code> 的方式定义想要处理的节点，没有定义对应函数的节点会调用 <code class="language-plaintext highlighter-rouge">generic_visit</code> 函数，自动访问其子节点。</p>

<p>例如做 定义赋值检查（definite assignment analysis）时，
<code class="language-plaintext highlighter-rouge">AnalysisVisitor</code> 继承 <code class="language-plaintext highlighter-rouge">NodeVisitor</code> ，并在访问到函数定义时切换到针对 <code class="language-plaintext highlighter-rouge">FuncDef</code> 的类。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>class FuncHelper(NodeVisitor):
    def __init__(self):
        self.scope = Scope()
        
    def _has_error(self):
        return self.scope.has_error
    
    def visit_TypeDecl(self, node):
        # print 'TypeDecl', node.__class__.__name__
        self.scope.define_symbol(node._id.name, node._type)

    def visit_DeclStmt(self, node):
        # self.generic_visit(node.decl)
        self.visit_TypeDecl(node.decl)
        
    def visit_ContinueStmt(self, node):
        logging.error("continue outside loop!")
        self.scope.has_error = True

    def visit_BreakStmt(self, node):
        logging.error("break outside loop!")
        self.scope.has_error = True
        
    def visit_Assignment(self, node):
        if type(node.cast_expr) is VariableSymbol:
            self.scope.resolve_symbol(node.cast_expr.name)
        #helper = AssignmentExprHelper(self.scope)
        #helper.visit(node)
</code></pre></div></div>

<p>可以看到，在访问到声明和赋值语句时，会回调 <code class="language-plaintext highlighter-rouge">visit_TypeDecl</code> 和 <code class="language-plaintext highlighter-rouge">visit_Assignment</code>。</p>

<p>其中 <code class="language-plaintext highlighter-rouge">visit_TypeDecl</code> 会在符号表中注册该变量，而 <code class="language-plaintext highlighter-rouge">visit_Assignment</code> 会检测该变量是否存在于符号表中(同时也可以检测变量的类型和赋值的对象是否相同)。</p>

<p>而 <code class="language-plaintext highlighter-rouge">visit_BreakStmt</code> 和 <code class="language-plaintext highlighter-rouge">visit_ContinueStmt</code> 则会检查是否有循环外的 break 和 continue 语句。因为循环语句会触发 <code class="language-plaintext highlighter-rouge">visit_WhileStmt</code> ，进入 LoopHelper 对象进行下一步处理，在没有进去 LoopHelper 访问到的 break 和 continue 即为循环外定义的非法语句。</p>

<h2 id="中间代码生成">中间代码生成</h2>

<p>通常的代码生成过程为：源代码解析为的 AST 或者三地址代码，生成高级的中间代码(HIR)，然后可能会生成中级的中间代码(MIR)或低级的中间代码(LIR)，中间代码一般是机器无关的代码，最后编译器在中间代码的基础上生成机器相关的代码（例如 x86 汇编代码）。MIR 基本上适合大多是优化，HIR 则用于依赖分析等场景，LIR 用于明确指明寄存器和地址等的优化，参考《高级编译器的设计与实现》(鲸书)第四章《中间表示》。</p>

<p><img src="/imgs/CompilerGenerationFramework.png" alt="Compiler Generation Framework" /></p>

<p>最常见的 HIR 即为抽象语法树(AST)，而 MIR 需要表示源代码的变量、临时变量、寄存器，能够把控制流归约为简单的有条件跳转和无条件跳转、函数调用(call)、和返回(ret)，还需要用明显的操作来支持块结构(BasicBlock)和过程(Function)。</p>

<p>BasicBlock 是 CFG 的基本组成部分，有一系列除了头和尾没有分支的代码序列，一个 BasicBlock 中的代码会按顺序依次执行。</p>

<p>一个 BasicBlock 只能有一个入口(entry point)，意味着 BasicBlock 中的代码不能是某个跳转指令的目标。
一个 BasicBlock 只能有一个出口(exit point)，代表只有 BasicBlock 中的最后一条指令才允许跳转到另外的 BasicBlock 中开始执行。</p>

<p>BasicBlock(简称 BB 块)之间的关系为，BB块 结束后跳转的目标称作 successors，一个 BB 块可能有多个 successors （条件跳转）。 跳转到先有 BB 块的称作 predecessors，一个 BB 块也可能有多个 predecessors。</p>

<p>下面将以 clang 和 gcc 为例，通过下面的 testif.c 来说明常见的中间代码形式和生成过程。</p>

<p>testif.c</p>
<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>int main()
{
  int a = 1;
  if (a &gt; 0) {
      return 1;
  }
  return 0;
}
</code></pre></div></div>

<h3 id="clang-中的中间代码生成">Clang 中的中间代码生成</h3>

<p>Clang 中会先将 AST 划分为 CFG(<a href="https://en.wikipedia.org/wiki/Control-flow_graph">Control-flow_graph</a>), 用于进一步的分析和平台无关的优化。然后再以类似划分 CFG 的逻辑划分 Basic Blocks，并生成三地址代码。</p>

<p>Clang 中会生成 LLVM 的 IR，再调用 LLVM 生成目标机器码，使用 <code class="language-plaintext highlighter-rouge">clang  -S -emit-llvm $1</code> 可以 dump 出 Clang 生成的 LLVM IR。以下面的测试代码为例:</p>

<p>生成的 testif.ll 代码如下：</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>define i32 @main() #0 {
  %1 = alloca i32, align 4
  %2 = alloca i32, align 4
  store i32 0, i32* %1, align 4
  store i32 1, i32* %2, align 4
  %3 = load i32, i32* %2, align 4
  %4 = icmp sgt i32 %3, 0
  br i1 %4, label %5, label %6

; &lt;label&gt;:5:                                      ; preds = %0
  store i32 1, i32* %1, align 4
  br label %7

; &lt;label&gt;:6:                                      ; preds = %0
  store i32 0, i32* %1, align 4
  br label %7

; &lt;label&gt;:7:                                      ; preds = %6, %5
  %8 = load i32, i32* %1, align 4
  ret i32 %8
}
</code></pre></div></div>

<p>可以看到 C 代码中的 if 语句编译为了 icmp 和 br，然后 if 和 else 分支分别对应 label 5 和 label6。
而 label 7 为 if 后续的语句，可以看到 label 7 的注释中标注有 preds = %6, %5，其代表着 label 7 的前置 label 为 5 和 6，这代表了 BasicBlock 间的关系。除了第一个 BasicBlock，如果某个 BasicBlock 没有前置的 BasicBlock，则该分支为无效的分支。下面我们将一起来看一下 BasicBlock 的具体概念。</p>

<h3 id="gcc-中的中间代码生成">GCC 中的中间代码生成</h3>

<p>以上面的 <code class="language-plaintext highlighter-rouge">testif.c</code> 为例，使用 <code class="language-plaintext highlighter-rouge">gcc -fdump-tree-all testif.c</code> 可以 dump 出 gcc 中的中间语言 gimple(<code class="language-plaintext highlighter-rouge">.gimple</code> 文件，为高级的中间表达式) 以及 cfg(<code class="language-plaintext highlighter-rouge">.cfg</code> 由高级的gimple生成低级的中间表达式)。</p>

<p>上面的 <code class="language-plaintext highlighter-rouge">testif.c</code> 生成的 cfg 如下</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>;;  nodes: 0 1 2 3 4 5
;; 2 succs { 3 4 }
;; 3 succs { 5 }
;; 4 succs { 5 }
;; 5 succs { 1 }
main ()
{
  int a;
  int D.1798;

  &lt;bb 2&gt; [0.00%]:
  a = 1;
  if (a &gt; 0)
    goto &lt;bb 3&gt;; [0.00%]
  else
    goto &lt;bb 4&gt;; [0.00%]

  &lt;bb 3&gt; [0.00%]:
  D.1798 = 1;
  goto &lt;bb 5&gt; (&lt;L2&gt;); [0.00%]

  &lt;bb 4&gt; [0.00%]:
  D.1798 = 0;

&lt;L2&gt; [0.00%]:
  return D.1798;

}
</code></pre></div></div>

<p>关于 gcc 的 gimple 中间表达式可以参考 https://www.cse.iitb.ac.in/grc/gcc-workshop-09/downloads/gccw09-gimple.pdf，其主要关注下面三个方面：</p>
<ul>
  <li>简化控制流：将代码转换为简单的一系列语句(statment) 和 跳转。</li>
  <li>简化表达式：例如 <code class="language-plaintext highlighter-rouge">-=</code>、<code class="language-plaintext highlighter-rouge">+=</code></li>
  <li>简化作用域：将变量包括临时变量移动到作用域开始处</li>
</ul>

<h3 id="naivecompiler-中的中间代码生成">NaiveCompiler 中的中间代码生成</h3>

<p>NaiveCompiler 中构建 CFG 后没有进行接下来的分析操作，直接开始做代码生成。</p>

<p>在做完语义分析生成 AST 之后 NaiveCompiler 将循环和条件语句改写为中间代码，分成多个 Baisc Block，并序列化中间代码的语法树，提供给后端 C++ 引擎以便调用 LLVM 来生成 IR 最后编译为目标文件。</p>

<p>示例的 <code class="language-plaintext highlighter-rouge">testif.c</code> 对应的语法树如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>python compiler.py --show-ast tests/testif.c 
----------- show ast ------------
AST: 
  FuncDef: return_type=int, storage=extern
    MethodSymbol: name=main
    DeclarationList: 
    StmtList: 
      DeclStmt: 
        TypeDecl: _type=int, storage=auto
          VariableSymbol: name=a
          Const: _type=int, val=1
      IfStmt: 
        BinaryOp: op=&gt;
          VariableSymbol: name=a
          Const: _type=int, val=0
        StmtList: 
          ReturnStmt: 
            Const: _type=int, val=1
      ReturnStmt: 
        Const: _type=int, val=0
</code></pre></div></div>

<p>因为后端使用 LLVM 来做代码生成，NavieCompiler 前端中生成的中间代码需要配合 LLVM，考虑 LLVM 代码生成的 API 中，是以 BasicBlock 为基本模块的，并且并无 if 等条件语句，和 for、while 等循环语句，而是类似汇编中的 cmp 语句，和跳转语句 br。（区别为 x86 汇编中 cmp 只有一个，cmp 后会设置条件寄存器，然后有多种 jmp 语句来根据条件寄存器的标志位进行跳转。而 LLVM 的 IR 中 cmp 可以传入比较参数，而跳转均为 br，br 可以带条件结果或者不带条件直接跳转）。</p>

<p>而 LLVM 中的代码(IR)都属于某个函数，而其基本的组成模块为 BasicBlock，每个 BasicBlock 都有一个编号，可以供其他 BasicBlock 跳转时使用。</p>

<p>NaiveCompiler 中 Basic Block 的生成逻辑实现在 <code class="language-plaintext highlighter-rouge">codegen.py</code> 中。
以上面的 <code class="language-plaintext highlighter-rouge">testif.c</code> 为例，使用 <code class="language-plaintext highlighter-rouge">python compiler --show-cfg</code> 得到 CFG 如下:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Func  main
4 Entry
Succs: [3]

3
DeclStmt:
  TypeDecl: _type=int, storage=auto
    VariableSymbol: name=a
    Const: _type=int, val=1
CMPJMP: id1=2, id2=1
  BinaryOp: op=&gt;
    VariableSymbol: name=a
    Const: _type=int, val=0
Succs: [2, 1]

2
ReturnStmt:
  Const: _type=int, val=1
Succs: [0]

1
ReturnStmt:
  Const: _type=int, val=0
Succs: [0]

0 Exit
Succs: []
</code></pre></div></div>

<h4 id="basicblock">BasicBlock</h4>

<p><code class="language-plaintext highlighter-rouge">codegen.py</code> 中，首先定义了 BasicBlock 的基本结构，按照上面的定义，一个基本块需要有一个独立的 ID，以及跳转到该基本块的前置基本块(preds)和该基本块的后续基本块(successors)，还需要 LoopTarget 和 Terminator 辅助循环语句的生成，当然，语句列表(stmts)也不能少。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>class BasicBlock(object):
    """ Hold a BasicBlock, To Replace AST Label"""
    BlockKind = ["Reachable", "Unreachable", "Unknown"] # 该 BasicBlock 是否可达
    def __init__(self):
        self.Label = None # Label
        self.Label_id = -1 # Label id
        self.block_id = id_generator.next() # block id
        self.block_name = ''
        self.stmts = [] # StmtList
        self.preds = []
        self.successors = []
        self.Terminator = None
        self.LoopTarget = None
</code></pre></div></div>

<h4 id="codegenerator">CodeGenerator</h4>

<p>代码生成时，以每个 Function 作为一个模块，每个模块由多个基本块组成，其中有一个默认得 Entry 和 一个 Exit 块。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>def build_basic_blocks(ast):
    basic_blocks = {}
    for c in ast.children():
        if c.__class__ is FuncDef:
            bb = CodeGenModule.build_basic_blocks(c.body, c)
            basic_blocks[c] = bb
    return basic_blocks
</code></pre></div></div>

<p>定义 <code class="language-plaintext highlighter-rouge">CodeGenerator</code> 用于代码生成，其中 cgm 存放当前模块的所有基本块，该类中定义的 <code class="language-plaintext highlighter-rouge">current_block</code> 和 <code class="language-plaintext highlighter-rouge">current_successor</code> 负责确定当前处理的基本块和当前块的后续基本块。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>class CodeGenerator(object):
    """ 至低向上构建 CFG，向构建继承的 block 再构建 上一层的 block"""
    Terminator_STMTS = ["BreakStmt", "ContinueStmt", "ReturnStmt"]
    def __init__(self):
        self.cgm = CodeGenModule()
        self.current_block = None
        self.current_successor = None
        self.break_jumptarget = None
        self.continue_jumptarget = None
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">CodeGenerator</code> 反向遍历 FuncDef 节点的 StmtList 子节点，构建 CFG。其代码参考了 Clang 的 <code class="language-plaintext highlighter-rouge">CFG.cpp</code>。</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code># CFG.cpp::1124
# https://code.woboq.org/llvm/clang/lib/Analysis/CFG.cpp.html#_ZN12_GLOBAL__N_110CFGBuilder11createBlockEb
def build_basic_blocks(self, node, parent):
    """ 将 StmtList 转换为 CFG，从尾向头遍历子节点"""
    assert node.__class__.__name__ == 'StmtList'
    self.current_successor = self.create_block() # exit Block
    self.current_block = None
    
    block = self.visit(node)
    
    if block is not None:
        self.current_successor = block

    return self.cgm
</code></pre></div></div>

<p>因为从尾向头遍历，所以先创建第一个默认的 Exit Block，并设置为 <code class="language-plaintext highlighter-rouge">current_successor</code>，这样遍历到倒数第一个语句时，将会自动创建一个基本块并将其 Exit Block 添加到其 successors 中。</p>

<p>因为 FuncDef 的第一个 node 为 StmtList，默认的 visit 函数会调用 <code class="language-plaintext highlighter-rouge">visit_StmtList</code></p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>def visit(self, node):
    """ Visit a Stmt.
    """
    node_class =  node.__class__.__name__
    # print node_class
    if issubclass(node.__class__, Statement) or node.__class__ is StmtList:
        method = 'visit_' + node_class
        visitor = getattr(self, method)
    else:
        logger.warning("Unsupported Stmt: {0}".format(node_class))
        sys.exit(1)
    return visitor(node)
</code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code># https://code.woboq.org/llvm/clang/lib/Analysis/CFG.cpp.html VisitCompoundStmt
def visit_StmtList(self, node):
    last_block = self.current_block
    for c in node.children()[::-1]:
        tmp = self.visit(c)
        if tmp:
            last_block = tmp
    return last_block
</code></pre></div></div>

<p>可以看到 <code class="language-plaintext highlighter-rouge">visit_StmtList</code> 会反向遍历其子节点，即每个 Stmt，并返回最后一个不为空的基本块，如果没有发生运行错误，该块应为 Entry Block。</p>

<h3 id="refs">Refs</h3>

<p>https://en.wikipedia.org/wiki/Basic_block
https://www.cse.iitb.ac.in/grc/gcc-workshop-09/downloads/gccw09-gimple.pdf
http://amnoid.de/tmp/clangtut/tut.html</p>]]></content><author><name>admin</name></author><category term="compiler" /><summary type="html"><![CDATA[NaiveCompiler 前端设计]]></summary></entry><entry><title type="html">编译器开发从零单排(1)</title><link href="/2019/02/16/%E7%BC%96%E8%AF%91%E5%99%A8%E5%BC%80%E5%8F%91%E4%BB%8E%E9%9B%B6%E5%8D%95%E6%8E%92(1)/" rel="alternate" type="text/html" title="编译器开发从零单排(1)" /><published>2019-02-16T00:00:00+00:00</published><updated>2019-02-16T00:00:00+00:00</updated><id>/2019/02/16/%E7%BC%96%E8%AF%91%E5%99%A8%E5%BC%80%E5%8F%91%E4%BB%8E%E9%9B%B6%E5%8D%95%E6%8E%92(1)</id><content type="html" xml:base="/2019/02/16/%E7%BC%96%E8%AF%91%E5%99%A8%E5%BC%80%E5%8F%91%E4%BB%8E%E9%9B%B6%E5%8D%95%E6%8E%92(1)/"><![CDATA[<h2 id="前言">前言</h2>

<p>几年之前就想写一个系列的博客，记录一下从大学上完编译原理课后，不断尝试自己编写一个 C 语音编译器的过程。</p>

<p>在不断尝试的过程中，最大的感触有两个。</p>

<ul>
  <li>
    <p>不要太高估自己的时间和精力，不要把目标定的太高。</p>

    <p>做为互联网公司中的一线开发人员，在KPI的压力下，能够完成工作内容并学习一些工作相关的知识，已经很不容易了。只有在偶尔不加班的周末，或者下班以后十一二点到凌晨两点的安静的夜晚，才有时间分给写业余的出于爱好的代码，这也是工作之后写代码写的最开心的时间了。</p>
  </li>
  <li>
    <p>参考成熟的大型的有广泛应用的项目代码(Clang, LLVM)，先模仿学习。</p>

    <p>结合理论阅读、调试代码，尝试把其每一步生成中间结果的步骤和逻辑分清楚。在此基础上选择自己熟悉的工具，设计好整个项目再分步实现。</p>
  </li>
</ul>

<p>这些尝试产生的结果即为 <a href="https://github.com/Mithrilwoodrat/naivecompiler">naivecompiler</a>，一个由 Python、C++ 混合编写，基于 PLY 和 LLVM 的 C 语言子集编译器。</p>

<p>本来是打算先实现了计划中要支持的所有特性再开始写博客的，可是随着一年年的工作，发现要像国外的程序员抽出完整的时间做自己的 Side Project 是件过于奢侈的事，完成所有的特性遥遥无期。只能从长计议，边写代码边写博客，记录下学习过的理论知识、读源码的感悟、调试的心得，免得还没等到写完那一天就把这些都忘光了。</p>

<p>该项目主要参考 《编译原理》（龙书）， <a href="https://github.com/eliben/pycparser">pycparser</a>， <a href="https://github.com/dabeaz/ply">PLY</a> 以及部分 GCC 和 <a href="https://github.com/llvm-mirror/clang">Clang</a> 的代码。</p>

<p>以及使用 Clang 的命令行参数，dump 出每一步的中间结果，用于参考。</p>

<h2 id="典型编译器的结构">典型编译器的结构</h2>
<p>一个典型的静态语言编译器一般分为以下几个部分</p>

<ul>
  <li>词法分析 (Lexical analysis)</li>
  <li>语法分析 (Syntax analysis)</li>
  <li>语义分析 (Semantic analysis)</li>
  <li>中间代码生成 (Intermediate representation code generation)</li>
  <li>平台无关的代码优化 (Machine independent optimizations)</li>
  <li>代码生成 (Code generation)</li>
  <li>平台相关的代码优化 (Machine dependent optimizations)</li>
  <li>目标文件的生成 (Object File generation)</li>
</ul>

<p align="center">
  <img src="/imgs/compiler_construction.png" />
</p>

<p>在此之外，将目标文件链接为可执行文件或者动态、静态链接库虽然是属于链接器的工作，但日常使用中我们一般也是通过编译器命令完成链接的过程，如 <code class="language-plaintext highlighter-rouge">gcc hello.c -o hello</code> ，该命令最终会生成一个名为 hello 的 ELF 可执行文件。</p>

<p>根据维基百科上 <a href="https://en.wikipedia.org/wiki/Compiler">Compiler</a> 的定义，
一个 Compiler 可以分为 3 部分，即 Front end、Middle end、Back end。</p>

<p>上面提到的 8 个步骤中，词法分析、语法分析、语义分析、中间代码生成属于 Front end，平台无关的代码优化属于 Middle end，代码生成、平台相关的代码优化、目标文件的生成则属于 Back end。</p>

<p>在 Clang 中，大致的编译流程为经过词法、语法分析后生成 AST。然后基于 AST 生成 CFG 进行各类 Analysis，然后也基于 AST 划分 BasicBlock ，调用 LLVM 进行代码生成。上述的流程是基于之前阅读 Clang 源码后凭记忆得出，同时也参考了 Github 上有人写过的 <a href="https://github.com/yejinlei/about-compiler/blob/master/%E6%9C%89%E5%85%B3LLVM.md#clang%E6%B5%81%E7%A8%8B%E5%88%86%E6%9E%90">clang 流程分析</a>，如有错误请不吝赐教。</p>

<h2 id="naivecompiler-的框架设计">naivecompiler 的框架设计</h2>

<p><a href="https://github.com/Mithrilwoodrat/naivecompiler">naivecompiler</a> 中，前端的词法、语法、语义分析是用 Python 基于 PLY 框架实现的，后续的中间代码生成、和基于中间代码的分析也是基于 Python 实现。生成好中间代码后以序列化的方式生成中间文件，然后在 C++ 后读取序列化文件。代码生成以及后端的优化、目标文件生成都是在 C++ 中封装 llvm api 实现。</p>

<h3 id="目录结构">目录结构</h3>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>naivecompiler git:(llvm-6.0) tree -C -L 1
.
├── Docker
├── README.md
├── Structure.py
├── analysis_handler.py
├── ast_rewrite.py
├── backend
├── build.sh
├── c_ast.py
├── c_parser.py
├── cfgbuilder.py
├── clean.sh
├── codegen.py
├── compiler.py
├── demo
├── interface.py
├── libNaiveScript.so
├── link.sh
├── llvm.py
├── ns.data
├── parser.out
├── parsetab.py
├── requirements.txt
├── serialize_handler.py
├── serialize_structure.py
├── symbol_table.py
├── test.sh
├── tests
└── visitor.py
</code></pre></div></div>

<p>其中，<code class="language-plaintext highlighter-rouge">compiler.py</code> 为整个项目的入口。编译的过程为:</p>
<ul>
  <li>调用 <code class="language-plaintext highlighter-rouge">c_parser.py</code> 中的词法、语法分析模块，按 <code class="language-plaintext highlighter-rouge">c_ast.py</code> 生成 AST。</li>
  <li>然后调用 <code class="language-plaintext highlighter-rouge">codegen.py</code> 中的<code class="language-plaintext highlighter-rouge">build_basic_blocks</code> 将 AST 按 basic block 划分，生成中间代码。</li>
  <li><code class="language-plaintext highlighter-rouge">compile</code> 函数中调用 <code class="language-plaintext highlighter-rouge">SerializeHandler</code> 将 AST 序列化，并调用 <code class="language-plaintext highlighter-rouge">dump_stringtable</code> 将环境变量中的字符串表一同序列化生成最后的序列化文件。</li>
  <li>加载后端 c++ 链接库，读取序列化文件。</li>
  <li>后端解析序列化文件，调用 LLVM API 生成 LLVM IR。</li>
  <li>根据 IR 调用 LLVM API 生成对应的目标文件。</li>
</ul>

<h2 id="总结">总结</h2>

<p>在后续的几篇文章中，我们将陆续分前后端以 NaiveCompiler 和 Clang 为例介绍一个C语言子集的典型的静态编译器的各个部分，以及 PLY 和 LLVM 的使用和编译器编写中常用的模式和数据结构。</p>

<ul>
  <li><a href="/2019/02/16/编译器开发从零单排%282%29/">编译器开发从零单排(2)</a> 中将介绍如何使用 PLY 进行词法、语法分析，生成 AST。</li>
</ul>

<h2 id="refs">Refs</h2>
<ul>
  <li>https://norasandler.com/2017/11/29/Write-a-Compiler.html</li>
  <li>https://dsprenkels.com/compiler-construction.html</li>
</ul>]]></content><author><name>admin</name></author><category term="compiler" /><summary type="html"><![CDATA[前言]]></summary></entry></feed>